纽约 Ezoic 闭门工作坊实录:当 AI 杀死纯信息流量,第一方数据如何让单访客收益暴涨 45%

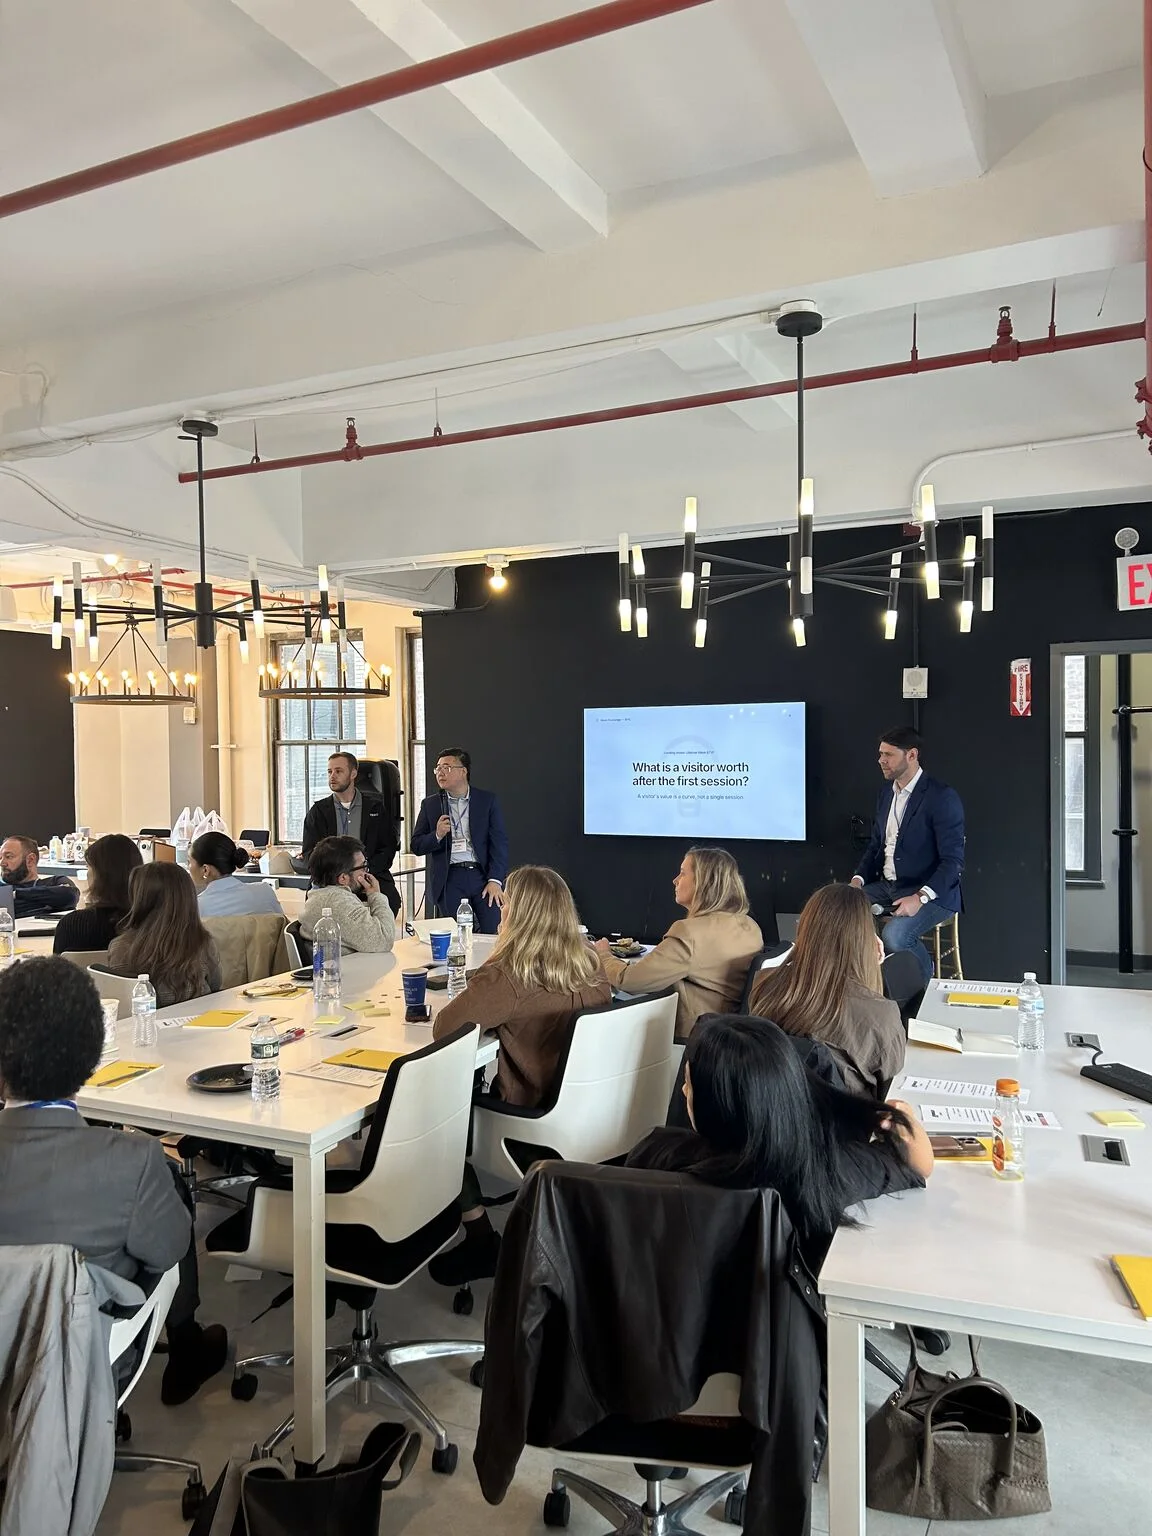
9 月 24 日(刚好赶上纽约联合国大会周和气候周),我受广告技术平台 Ezoic 邀请飞了一趟纽约,在曼哈顿中城的一间 Loft(楼上还带一个露天屋顶)里参加了一场只有大约 40 人的闭门工作坊:Media Enthusiast: Ideas Exchange — Turning First-Party Data Into Revenue(把第一方数据变成收入)。
我在《做内容站,赚广告钱:我的被动收入打法》里系统写过我用 AI 做免费内容站、靠展示广告赚被动收入的整体思路。那篇讲的是「一人公司」怎么从零把流量和矩阵做起来;而纽约这一整天,是我第一次以「出版商(Publisher)」的身份,坐进美国主流媒体和 Newsletter 操盘手的圈子里,和《华尔街日报》(WSJ)、CNN、1440、Charter、Beehiiv、WBUR 等三十多家媒体的负责人关起门来算细账。
当天上午,我和我的 Ezoic 客户经理 Nathan Horton 作为开场第一组案例嘉宾上台,由 Inbox Collective 创始人 Dan Oshinsky 对我们做了一场 25 分钟的深度访谈和现场演示;下午是 Dan 的方法论串讲、两轮四人小组的白板脑暴,以及全场的痛点会诊;晚上五点散场后,一群人又步行去第九大道的意大利砖炉披萨店 Capizzi 边吃边聊到深夜。
跟拉斯维加斯 CFP 大会流水账一样,这篇也把前后的筹备会、台上的分享、墙上八张大白板的手写笔记,以及饭桌上的闲聊完整整理出来:在「Google Zero」和 ChatGPT 吞噬传统搜索流量的今天,这群美国媒体人到底在焦虑什么、哪些搞钱和收数据的野路子真的管用,以及一个写代码的硅谷工程师坐在这群编辑和发行人中间,看到的代差到底在哪里。
一、这场闭门会是什么来头,屋里坐着些什么人
先交代一下这场活动的背景和组局的人。
主办方叫 Media Enthusiast(前身是 Newsletter 圈很有名的 Newsletter Enthusiast 和广告情报库 Who Sponsors Stuff),两位联合创始人是 Ryan Sager(早年给《华尔街日报》和《纽约邮报》写专栏)和 Jesse Watkins。
全场的主持人(Exchange Leader / MC)是 Dan Oshinsky。如果你做英文 Newsletter,大概率听过他的名字:他是《纽约客》(The New Yorker)历史上第一位 Newsletter 总监,之前在 BuzzFeed 管 Newsletter 增长(当年 BuzzFeed 靠测验和邮件裂变跑出海量流量的那套打法就是他带队做的),后来出来创办了咨询机构 Inbox Collective,专门帮独立新闻编辑室、非营利媒体和创作者搭邮件增长与变现体系。
Dan 在开场时讲了个花絮:几年前在芝加哥的一辆出租车后座上,他跟 Ryan 和 Jesse 提了个想法——大家都受够了那种上千人、台上念 PPT、台下刷手机的行业大会,能不能找间屋子,只请 25 到 40 个真正管业务的媒体操盘手,不准记名引用(off-the-record),甚至请大家关掉自动转写全场的 AI 会议记录工具,花一整天时间只死磕一个具体问题?今年 9 月这场纽约聚会,就是他们落地的第一场 Ideas Exchange。
三家赞助商:分别卡在媒体变现链条的哪一环
把这场活动攒起来的三个赞助方,恰好对应了今天独立媒体变现的三块基础设施:
- 冠名赞助商 Ezoic(程序化广告、身份图谱与收益优化):
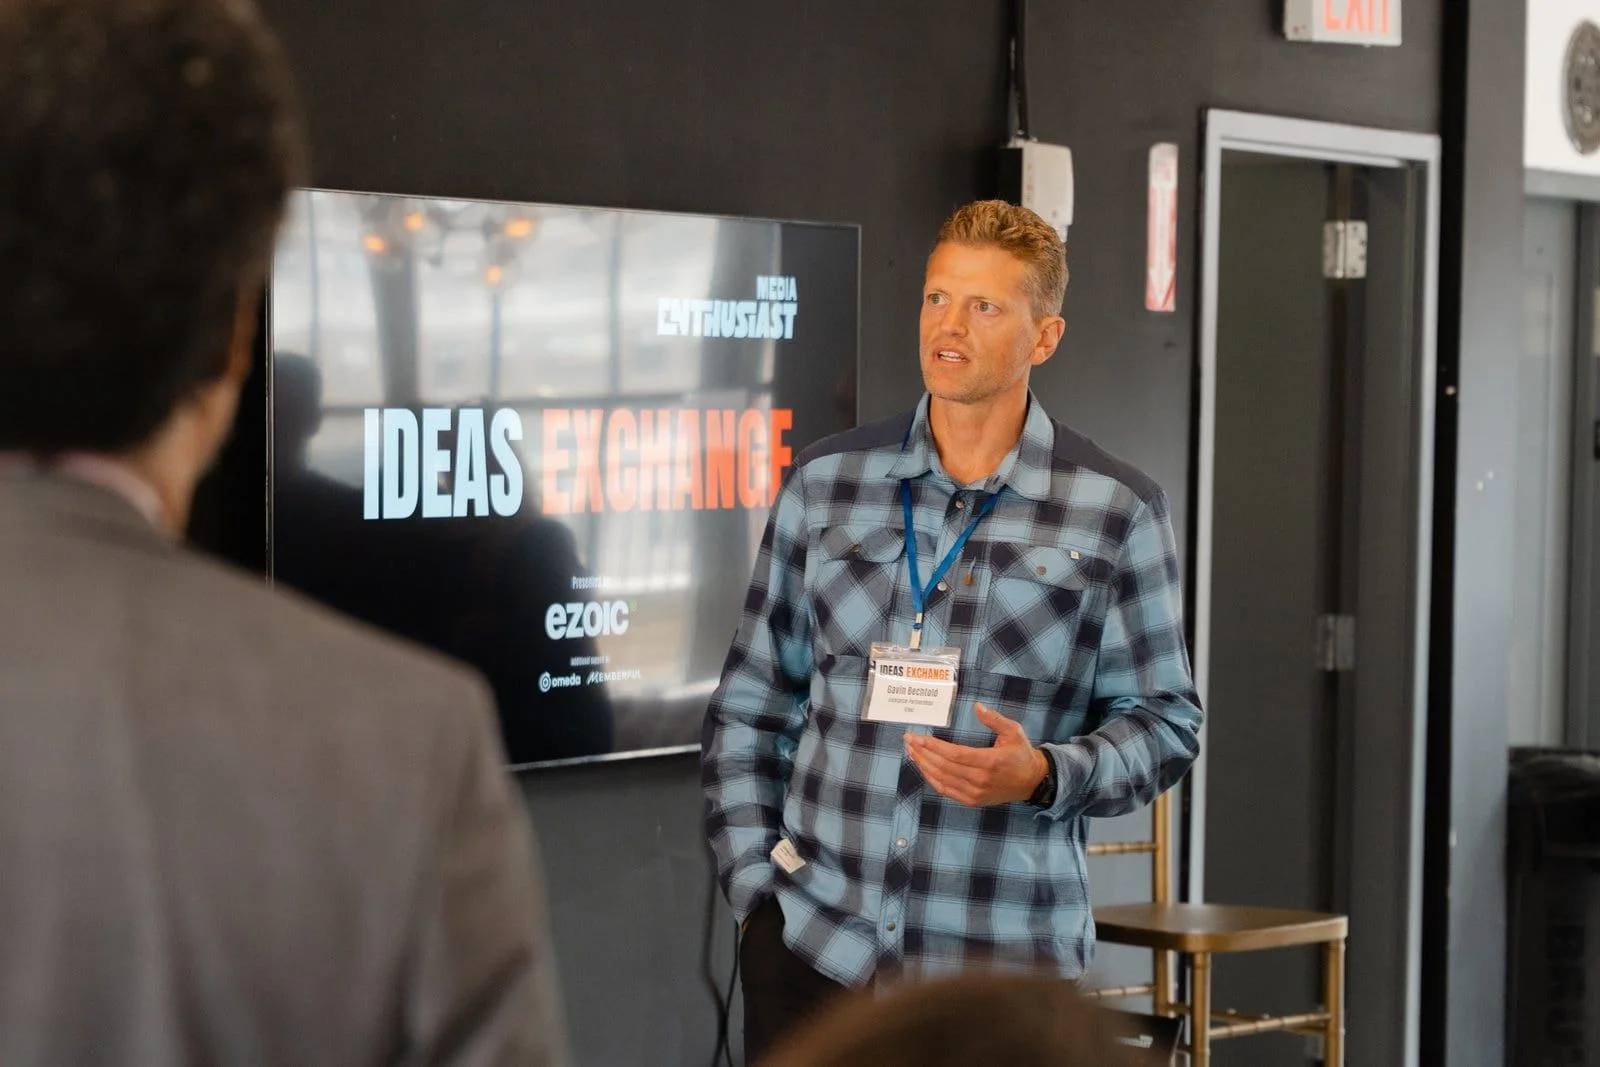
当天从圣路易斯飞过来的企业合作负责人 Gavin Bechtold、战略合作总监 Piper Lofrano(两人加起来有超过 20 年的出版行业资历),以及直接对接我们这些出版商做长期策略的 Nathan Horton 都在现场;9 月初帮我和 Dan 攒线上筹备会的还有他们团队的 Alyssa。
很多做独立站的人知道 Ezoic,是因为它是 Google AdSense 往上走的主流进阶平台。但今年 Ezoic 在做的事情,已经远远不止「自动测广告位」了。结合 Gavin 和 Nathan 在现场讲的,以及 Ezoic 今年在全网跑出的几组硬数据,可以看到广告技术底层正在发生什么变化:
- 「覆盖率(Coverage)」是虚荣指标,确定性身份(Deterministic Identity)才是印钞机:绝大多数广告技术供应商喜欢吹嘘身份匹配覆盖率,把「概率猜测(Probabilistic)」和「实名验证(Deterministic)」混在一起算。但 Ezoic 全网的真实数据是:美国访客里只有约 6% 是确定性实名识别的,而这 6% 的访客贡献了全美网络近 20% 的总广告收入。这并不是因为他们点广告更多,而是当下游广告主百分之百确定屏幕对面是谁时,确定性身份自带 2 倍到 3.5 倍的 CPM 溢价。
- 毫秒级 AI 动态底价(Dynamic Bid Floors)与 AI 广告优化:传统出版商设一个静态底价就不管了,但广告竞价是按「用户、设备、地域、广告位、时间、竞价方」六个维度在毫秒间重新定价的。2026 年第一季度,Ezoic 全网 EPMV(每千访客收益)同比增长 27.1%,单季度爬升 38%;在 2026 年 1 月到 7 月针对平台上 900 多家大型网站的对照 A/B 测试里,开启 AI 广告优化的站点加权 EPMV 高出对照组 7.7%,而且差距每个月都在拉大(1 月 +5.6%,到 7 月扩大到 +11.3%,部分站点收入涨幅达 75%),因为 AI 不会进入平台期。
- 2026 年的新武器库:包括免广告位 ID 的
{showAds}脚本(支持 React/Vue/Angular SDK,还配了能直接连进 Cursor、Claude Code 或 MCP 工具的 AI Setup Assistant)、基于现有社交登录一键生成的 Visitor Accounts、针对 HTML5 网页小游戏的 Web Games SDK(激励视频广告的 CPM 是普通横幅展示广告的 6 到 15 倍)、能把自家网站过去 90 天收入和同赛道同行均值做匿名对比的 Niche Peer Index(同行指数看板)、支持切分流量并行跑实验的 Publisher Feature Testing,以及今年 7 月刚上线的 单用户 LTV(生命周期价值)追踪。
- 联合赞助商 Omeda(媒体专用 CDP 与受众数据平台): 现场来了 Dale Durrett、产品负责人 Bill(早年在道琼斯和 CBS 做生产与数据)、Kathryn Harriman 等人。Omeda 干的活,是把散落在网站行为、Newsletter 打开点击、线下活动、纸刊订阅里的非结构化数据,洗成统一的 360 度结构化用户画像。Bill 在自我介绍时说了一句大实话:在媒体公司里,做数据的人和写内容的人说的是两种完全不同的语言,经常鸡同鸭讲,导致收集上来的数据根本落不到变现上。
- 联合赞助商 Memberful(白标会员与订阅系统): 战略合作负责人 Jen Matichuk 在场。Memberful(Patreon 旗下)帮独立媒体、Newsletter 和教育创作者在自己的网站上搭建完全白标的付费会员体系。
屋里坐着的 30 多位同行都是谁
破冰环节,Dan 让大家拿着麦克风挨个介绍自己是谁、管什么业务、今天最想带走什么答案。听完一圈,我把屋里的参与者大致分成四类:
- 第一类是传统主流大媒体与公共媒体的受众/产品负责人:
- Vivian Tran(《华尔街日报》The Wall Street Journal 新闻编辑室受众策略负责人):统管 WSJ 的内容策略、SEO、社交媒体,当时正在组建一支把「社区」和「Newsletter」揉在一起的直接受众团队(Direct Audience Team)。她最关心两件事:怎么用第一方数据反哺编辑部做出留存率更高的订阅产品,以及怎么证明站外(Off-platform)受众增长项目的 ROI。
- Sydney Salazar(CNN Newsletter 产品负责人):刚履新不久。CNN 做 Newsletter 很早,但付费订阅业务是新的,她最头疼的是怎么让免费 Newsletter 和付费墙订阅协同增长,而不是互相抢流量(Cannibalization)。
- Brent(波士顿公共广播电台 WBUR / NPR 首席营收官 CRO):公共媒体的受众几乎全是捐款人(Donors),怎么在不惹恼捐款人的前提下建立第一方数据体系。
- Tom LaVecchia, MBA(《新泽西月刊》New Jersey Monthly 发行人):话讲得很实在——「我们不敢再像以前那样相信 Google 了」,老牌地区杂志急需搞清楚自有媒体怎么盘活、流量还能从哪来。
- David Fitzpatrick(管理着 60 多本多元文化出版物的首席商务官 CCO),以及来自《纽约邮报》(New York Post)、《新闻日报》(Newsday)、《福布斯》(Forbes)、The Athletic 等机构的同行。
- 第二类是新媒体、Newsletter 原生机构与平台方:
- Jay Lauf(未来工作研究与媒体机构 Charter 联合创始人;此前曾任商业媒体 Quartz 的总裁兼发行人,以及《大西洋月刊》The Atlantic 的发行人)。
- Phoebe Bain(日更商业与科技简报 1440 的商业与金融编辑;此前在 Morning Brew 一手创办了 Marketing Brew)。1440 是美国增长最猛的免费日更 Newsletter 之一,Phoebe 说自己虽然在编辑部,但在创业公司里,编辑必须懂商业模型和第一方数据是怎么转的。
- Tyler Morin(财经日更 Newsletter The Water Coolest 创始人、Newsletter 增长顾问,同时也是行业唯一一档专门聊 Newsletter 的直播节目 Letterland Live 的联合主持人)。
- Francis Zierer(Newsletter 平台 Beehiiv 的 Creator Spotlight 主理人,每周深度访谈一位创作者的搞钱模式)。
- Dave Gerlach(Quoted Network 创始人):给全美地方公共广播电台、文化机构和新闻编辑室搭了一套内容分发与赞助聚合平台,背后连着全美公共媒体约 1,500 万名捐款人的参考数据库,想帮那些只会喊「捐款、收听、买票」的老牌机构把受众真正激活起来。
- 第三类是垂直赛道、创作者媒体与智库/教育生意:
- Daniel Ghosh-Roy(全美最大的匹克球垂直媒体 The Dink 的首席运营官 COO)。
- Amber(畅销书作家 Gretchen Rubin 旗下 Gretchen Rubin Media 的负责人,管着庞大的个人成长 Newsletter 与播客矩阵)。
- Christian Wattig(FP&A Prep 创始人):离开企业界三年,跟沃顿商学院在线教育(Wharton Online)合作教企业财务规划与分析(FP&A),手上有一个 3.5 万订阅的 Newsletter 和 1.8 万订阅的 YouTube 频道,正准备招第一个全职员工。
- Ryan McBride(Level Up in NYC 创始人):此前在奥巴马基金会(Obama Foundation)做全球项目,上个月刚全职投入自己孵化了三年的纽约本地职场晋升与财富积累媒体,兼做周更 Newsletter、播客、线下社交活动,还拿下了纽约市教育局(NYC DOE)进校办工作坊的合同。
- Eric Rojas(美国外交关系协会 Council on Foreign Relations 邮件与数据运营):一个人管着智库旗下大约 30 份不同的 Newsletter,打通技术端数据与日常发信。
- 此外还有 Jaime Plumaker(数据分析与机器学习受众激活负责人)、Jessanne Collins(负责电商与导购内容垂直赛道)、Anne Mercogliano、Michael Rothman、Reginald Ferguson、Susie Plotkin 等三十多位同行。
- 第四类,大概就只有我一个「异类」: 轮到我拿麦的时候,我说我是从旧金山飞过来的陈然,本职是医疗器械全球注册公司 Pure Global 的 CTO,业余一个人用 AI 做了免费备考题库网站 Open Exam Prep。
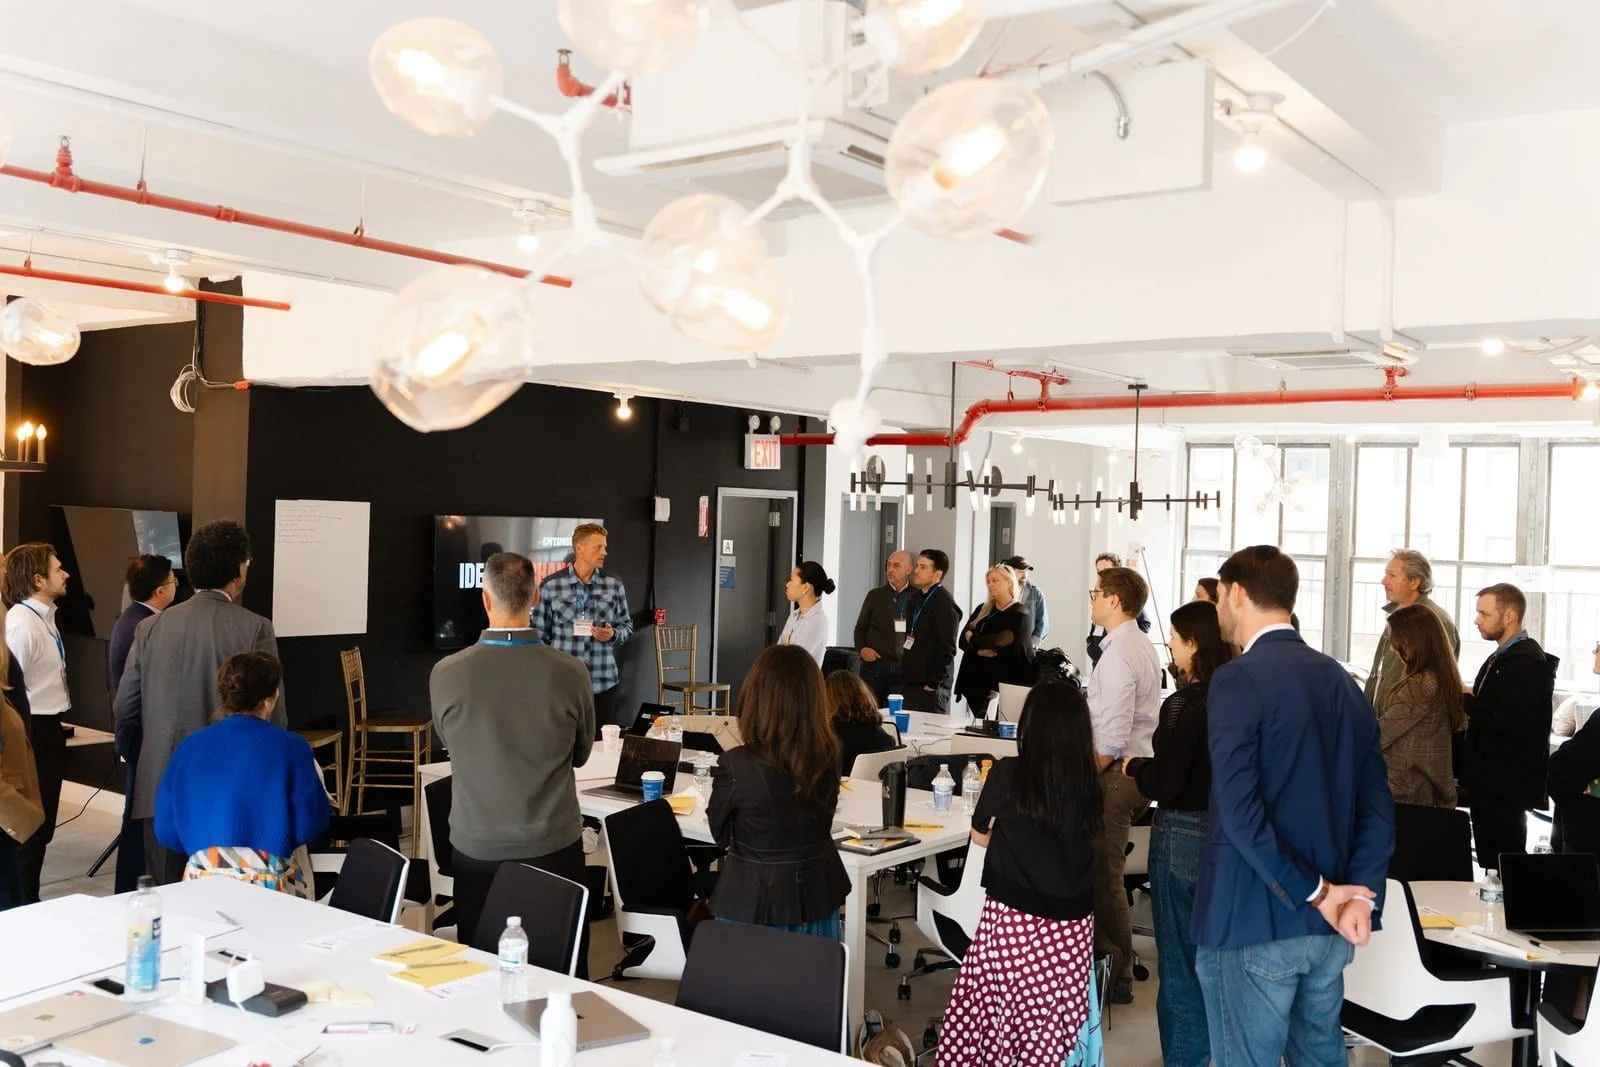
为什么 Ezoic 会选我这样一个「出版圈外人」做开场第一个案例?在 9 月 1 日的线上筹备会上,Ezoic 的 Alyssa 说了一句让我印象很深的话:在他们眼里,虽然我既没有记者也没有销售团队,但我这种「靠长尾自然流量获客、极度看重页面停留时长、并且愿意用 AI 和登录钩子沉淀第一方身份数据」的站点,恰恰是接下来几年最有生命力的典型出版商画像(ICP)。
二、开场案例分享:我怎么用「免费题库 + AI 讲解钩子」把 EPMV 拉高 45%
自我介绍一结束,Dan Oshinsky 就叫我和 Ezoic 的 Nathan Horton 一起上台。
在筹备会上,Dan 就跟我们商量好了一个细节:千万别做十几页 PPT,因为台下坐的全是老油条;一上来先用两分钟在投屏上现场操作一遍网站,免得大家一边听一边低头拿手机搜你的域名。
1. 为什么一个硅谷工程师会跑去建一万个考试的题库?
Dan 先问我:Open Exam Prep 是什么,你为什么要做这个东西?
我讲了两个背景。第一个背景在《人生的秘密,竟然是 Beta》里写过:前两年在湾区当全职爸爸带娃的时候,我有大量的碎片时间,又是个很典型的「做题家」,就顺手考了寿险执照、证券执照(Series 6/63/65)、国税局注册税务师(EA)、注册理财规划师(CFP)、房产经纪人等十几个证。考了一圈我发现一个巨大的痛点:市面上那些收费几百上千美元的备考题库和教材,质量其实烂得惊人;反而我把官方考试大纲(Blueprint)喂给 AI,让 AI 帮我出题、拆解知识点,效果比付费教材好得多。
第二个背景是我的上一份工作——我在免费流媒体平台 Tubi(可以理解成「免费带广告版的 Netflix」)干了好几年。Tubi 给我的商业信仰就三条:完全免费(无付费墙、免注册)、超长尾覆盖、质量做到中上(Above-average quality)。
最初我只做了大概 20 个我熟悉领域的考试。做完之后我问 AI:「这玩意儿能不能规模化?」AI 帮我把全美所有行业协会、州政府执照局、技术认证机构爬了一遍,我才震惊地发现:全美国竟然有超过 10,000 到 20,000 种不同的资格考试和证书。 我在台上开玩笑说,美国有无数机构靠发明各种新证书赚钱,因为大家喜欢花钱考个证,好把自己在 LinkedIn 名字后面的字母头衔越拉越长。
传统教育公司做一个考试的题库要雇教研团队,所以全网绝大多数备考网站只盯最热门的那 10 到 100 个大考试(比如 MCAT、CPA、Bar Exam),剩下的一万多个长尾考试几乎是真空地带。我用 AI 搭了一套庞大的分类体系(Taxonomy),把覆盖面直接铺到了一两万个考试、两百多万道免费练习题。今年 1 月从零起步,一分钱获客费没花,纯靠 Google 和 Bing 的自然搜索(Programmatic SEO),不到一年时间做到了月独立访客约 50 万、月页面浏览量(PV)约 100 万。
2. 纯信息内容已经死了:为什么我的博客页干脆不放广告?
Dan 在投屏上随便点进了一个 AI 相关的考试页面,页面上有四个模块:练习题(Practice Questions)、学习指南(Study Guides)、速查表(Cheat Sheets)和闪卡(Flashcards)。Dan 问我:你是怎么靠这套东西赚钱的?
我给出了当天在场很多传统媒体人听完眉头一紧的第一个判断:纯信息类内容(Informational Content)的商业价值正在自由落体,我在自己网站的博客和资讯页上甚至干脆不放广告了。
原因很简单:当一个考生想知道「亚利桑那州的公证员考试报名费是多少」「CFP 考试一年考几次」这种纯信息问题时,他今天直接去问 ChatGPT、Claude,或者看一眼 Google 搜索结果顶部的 AI Overview 就够了。哪怕大模型在回答底下附了你的网站引用链接(Citation),用户也根本不会点进来。更残酷的是,年轻一代里愿意静下心来读完一篇长博客的读者越来越少。
但「做题」不一样。AI 可以替你总结一篇文章,却没办法替你把题刷了。
在 Tubi 的时候,我们的北极星指标只有一个,叫 TVT(Total View Time,总观看时长),因为广告收入和用户停留时长是 1:1 绑定的。我把同样的逻辑搬到了网站上:我发现学习指南、文章、甚至闪卡,用户的停留时间都很短,看完就走;唯独交互式练习题(Interactive Practice Questions)是留存黑洞——用户一道题接一道题地做,跳出率极低,单次停留动辄几十分钟甚至几个小时。
所以我的策略非常极端:把展示广告主要集中在互动率最高、停留时间最长的练习题页面上,而把静态的指南和文章纯粹当成搜索引擎的漏斗入口。
3. 「Let's break it down with AI」:不惹毛用户的丝滑登录钩子
接着到了全场最核心的环节:既然网站主打「完全免费、免注册就能刷题」,我的第一方实名数据是从哪来的?
Dan 在台上当场选了一道单选题,故意选错了一个选项,页面立刻标红提示答错,紧接着下面出现了一个按钮:「Let's break it down with AI(让 AI 深度拆解这道题)」。Dan 一点这个按钮,屏幕上弹出了 Google One Tap / 单点登录(SSO)的注册框。
我在台上解释了这个设计的底层逻辑:
- 如果一个用户只是来刷题、看基础解析,我什么都不拦,他的做题记录直接存在浏览器的本地存储(
localStorage)里,我一丁点个人信息都不收。 - 但只要他是认真备考的人,做错了一道题,基础解析没看懂,他想追问「为什么 B 不对」「背后的计算公式是什么」,或者他想跨设备同步自己的错题本和学习进度,他就必须点那个 AI 按钮。
- 这时候弹出登录框,用户的心理接受度极高——因为所有人都知道调用大模型是要花钱的(我会在登录后送他免费 AI 额度),而且他刚刚在一道具体的题目上卡住了,正处于求知欲最强的瞬间。
Dan 在台上点评了一句:「这也是我最喜欢这个设计的地方——它一点都不让人觉得鸡贼(doesn't feel sneaky)。很多媒体的注册墙是在强行打断用户,而这里是一场明码标价的价值交换(Clear exchange of value)。」
4. Nathan 算的那笔账:从 RPM 到 EPMV,登录用户如何带来 +45% 的收益跃升
这时候,我的 Ezoic 客户经理 Nathan Horton 接过话筒,在屏幕上放出了 Open Exam Prep 的后台数据对比,解释了两个让台下媒体高管狂记笔记的数字。
第一,为什么要抛弃 RPM,改看 EPMV(Earnings Per Thousand Visitors,每千名访客收益)? 传统媒体习惯看 RPM(每千次页面浏览收入)。但 RPM 有个致命缺陷:它只看单页,不看「人」。如果一个弹窗把单页广告塞满,RPM 看着很高,但用户看一页就恶心走了;而 EPMV 衡量的是「每来 1,000 个真实的人,在整个访问周期里一共给你赚了多少钱」。比如在 Open Exam Prep 上,我们的 EPMV 能稳定在 50 美元左右,远高于普通内容站,首先就是因为做题用户每次进来的浏览页数(Pages per visit)和停留时长远超阅读类网站。
第二,当用户通过 Google SSO 登录后,发生了什么? Nathan 给出了我们站点的实测数据:目前大约有 20% 的活跃访问处于 Google SSO 登录状态并携带第一方身份标识;算上行为和身份的双重叠加效应,实名识别将 Open Exam Prep 的整体 EPMV 直接拉高了约 45%(在单会话对比上,携带第一方身份的访问广告单价高出约 50%)!
为什么会有这么夸张的涨幅?Nathan 拆解了背后的双重复利效应(Compounding Effect):
- 行为层面的复利:愿意登录使用 AI 讲解和进度追踪的用户,本身就是高意向核心用户,他们的跳出率断崖式下降,单次会话时长翻倍。
- 竞价层面的复利(Identity Graphing):当用户一点 Google One Tap 登录,邮箱标识经过隐私安全的哈希加密(Hashed ID)后,通过 Ezoic 的身份图谱传给下游广告交易平台(SSP/DSP)。台下的 Dave Gerlach 追问了一句:「广告主拿到这个哈希值,到底是用来精准投这个人,还是做相似人群(Lookalike)?」Nathan 回答:两者都有——下游平台通过跨网哈希碰撞认出「这是住在犹他州帕克城的 Dan,或者他正在考某个金融牌照」,原本盲拍只敢出白菜价的广告主,为了这种确定性直接把出价(CPM)翻了 2 到 3 倍。
而在我们身后的大屏幕上,Ezoic 放出了他们从今年 7 月开始重点推的新指标——LTV(Lifetime Value,单用户生命周期价值)。那页 PPT 的副标题写得很精准:
“What is a visitor worth after the first session? A visitor's value is a curve, not a single session.”(一个访客在第一次访问之后还值多少钱?访客的价值是一条曲线,而不是一次会话。)
5. 我对未来的判断:廉价大模型让「千人千面(N=1)」第一次有了正 ROI
访谈的最后,Dan 问我:你现在真正的注册转化率其实还很低(大概只有 1% 到 5%),虽然攒了一个 Newsletter 邮箱列表,但甚至还一封邮件都没发过;未来一年你打算怎么把这批数据真正盘活?
我讲了我在工程和算法上思考最深的一件事:大模型推理成本的暴跌(比如 DeepSeek 以及各家的 Flash 级模型),正在彻底改写「极致个性化(Extreme Personalization)」与「数据收集」的 ROI 公式。
我在推荐系统和个性化领域干了快十年。过去,只有像 Netflix、Tubi 或字节跳动这样的大厂才玩得起真正的个性化,因为它太贵了:你要搭数据管道、要养昂贵的机器学习工程师团队训模型、还要付高昂的实时推理服务器成本。对中小媒体来说,过去所谓的「个性化」,顶多就是在发 Newsletter 的时候切 3 到 5 个分群(Segmentation)。
但我在台上直言:「分群(Segmentation)根本不是个性化(Personalization)。」
今天,因为大模型便宜到了近乎免费的地步,两件以前算不过账的事突然变得有利可图了:
- 一人一封的千人千面邮件 + 精准联盟导购(Affiliate):当用户在我的网站上做错了三道关于「亚利桑那州公证员法律责任」的题,并且跟 AI 聊了五轮,我手里就有了一份完整的「个人知识缺口日志」。我接下来发给他的邮件,不再是群发的模板,而是 AI 专门针对他昨天做错的那三道题写的复盘建议,顺手在邮件里挂上亚利桑那州公证员备考实体书的 Amazon 联盟链接或某门视频课链接。因为他真的在那道题上栽了跟头、主动求救过,这种推荐的转化率和相关性是群发邮件完全没法比的。(顺便吐槽了一句:我做完联盟链接才知道,按照合规要求,几乎每个页面角落都得写一行「我们可能从购买中获得佣金」的免责声明。)
- 用 AI 对话代替冷冰冰的问卷来收数据:以前你想知道用户的年龄、职业、备考目标,得求着他填表;现在你给他一个能陪他拆解错题的 AI 助教,在多轮对话里,用户会心甘情愿地把自己的背景、痛点和盘托出。互动本身,就是最高效的第一方数据收集器。
三、台下追问:匹克球媒体 COO 与「AI 找搜索供需缺口」的实战拆解
上午的环节一结束,还没等我咬上一口午餐的三明治,全美最大匹克球垂直媒体 The Dink 的 COO Daniel Ghosh-Roy 就端着咖啡过来找我,拉着我聊了整整二十分钟。
Daniel 的困惑极其典型,几乎代表了在场 80% 垂直媒体的处境: 匹克球是这两年全美增长最疯的运动,老少通吃、装备迭代快、社区粘性极高。他们的播客、Newsletter 和线下赛事赞助卖得非常好——每当有品牌要发布新款球拍,就会找他们定做原生内容,这笔钱赚得很爽,但 Daniel 把它叫做「Wildcard(看天吃饭的浮动收入)」。他真正渴望的,是让他们的网站变成一台每月产生稳定、可预测被动收入(Predictable Revenue)的机器。可问题是,他们雇了一位全职 SEO 专员,每天盯着那些搜索量最大的头部词写球拍测评和教学攻略,网站流量却始终不温不火。
我跟他拆解了我是怎么用「一个人 + 一群 AI」顶替过去一个 5 人编辑兼工程团队的:
- 人类编辑盯着头部红海肉搏,AI 专找「高需求、零供给」的长尾缺口:
人类编辑写一篇文章要花好几个小时甚至好几天,从成本核算上,他们本能地只会去抢搜索量最大的头部词(比如「2026 最佳匹克球拍」)。但那些词早就被大站卷成红海了。
我不用人去拍脑袋选题,而是直接把 Google Search Console、Google Analytics 和第三方关键词工具(比如 DataForSEO)的权限交给 AI,让 AI 自己去算搜索供需比(Supply and Demand Gap)。
我对 Daniel 举了个例子:没人会去人工写一篇专门针对「住在佛罗里达州、左手持拍、有网球肘的 65 岁以上老年初学者的粉色匹克球拍推荐」。但如果你把
[左右手] × [年龄段] × [所在州/气候] × [伤病痛点] × [球拍材质/颜色] × [技术水平]做成一个结构化的分类体系(Taxonomy),把这些维度交叉组合起来,底下藏着成千上万个真实有人在搜、但全网几乎没有专门页面的长尾需求。 - 「AI 找缺口 + 批量生成初稿 + 人做端到端体验把关」: 靠人工编辑去铺这一万个长尾词,ROI 必然是负的;但交给 AI,边际成本趋近于零。我现在自己已经几乎不手写代码和文章了,同时开着 ChatGPT、Claude、Claude Code、Gemini 和 Grok,走路的时候直接对着手机语音下指令,让 AI 去跑数据、改 SEO 结构、搭交互工具,我只站在最终用户的视角做端到端测试(End-to-End Testing)和数据分析。 而且长尾页面一旦做出规模,会产生一个意想不到的副产品:长线的品牌心智。当一个匹克球玩家无论搜多冷门的细分问题,排在第一的永远是你的网站,并且点进来还有个小工具能帮他算球拍配重时,他就会觉得「这家媒体什么都懂」。
Daniel 听完当场感叹:「我们的 SEO 专员天天只盯着最火的词死磕,但你说的长尾空白地带(White space),才是真正藏着稳定现金流的地方。」
四、Dan Oshinsky 的「用户阶梯(User Ladder)」与第一方数据收集武器库
吃完午饭(Dan 开玩笑说:「以前在媒体公司上班,老板想逼大家开数据复盘会,唯一的办法就是拿免费午饭行贿,今天居然有一群人吃完炸鸡排三明治还自愿留下来聊数据」),下午的重头戏正式开始。
Dan 先用半小时,把他给各家新闻编辑室做咨询的核心框架——User Ladder(用户阶梯)——完整地铺开了。
为什么要把「漏斗(Funnel)」倒过来变成「阶梯(Ladder)」?
Dan 说,所有做市场和运营的人,大学第一课学的都是营销漏斗(Funnel)。但漏斗思维在今天有个大毛病:它把注意力全放在了「筛人」上。而在收集第一方数据这件事上,更好的心智模型是一步一步往上爬的五级阶梯(User Ladder):
- Anonymous(匿名过客):从搜索或社交平台偶然点进来看一篇文章、听一期播客的飞鸟用户,看完就走,你完全不知道他是谁。
- Verified(已验证用户):给你留了一个邮箱地址(比如订阅了免费 Newsletter)。Dan 指出,绝大多数媒体走到这一步就停下来庆祝了——觉得拿到邮箱就能开始发广告、推活动、卖订阅了。但你除了一个邮箱字符串,对这个人一无所知:同样是《纽约邮报》的订阅者,他到底是来看纽约尼克斯队(Knicks)篮球报道的,还是来看 Page Six 娱乐八卦里《娇妻》(Real Housewives)撕逼的?(Dan 还补了一刀:千万别只信高雅的读者调研,很多人嘴上说自己订《纽约邮报》是为了看严肃政治评论,结果后台点击数据一拉,全在点《娇妻》八卦。)
- Known(已知画像用户):不仅有邮箱,你还拿到了关于他的 2 到 3 个可验证的核心标签(比如所在城市邮编、职业层级、核心兴趣或当前痛点),足以解锁真正的精准分群。
- Loyal(忠诚习惯用户):他开始跨产品跟你建立高频习惯——不仅打开邮件,还会回复你的 Newsletter、听你的播客、下你的 App、领你的电子书或报名线下活动。
- Paying(付费/高变现用户):最终转化为付费订阅会员、活动购票者,或者成为广告主愿意花 3 倍溢价精准投放的高价值受众。
从目标倒推问题,以及立刻能抄作业的 6 种收数据手法
怎么把用户从第 2 级(Verified)拉到第 3 级(Known)甚至更高?Dan 给出了两条铁律和六个具体案例:
- 铁律一:注册入口越简单越好,千万别在大门口查户口。 Dan 在屏幕上放了一张政治媒体 Politico 的订阅表单做反面教材:用户在输入邮箱的同时,被强制要求填行业、雇主等一堆必填项(All fields must be completed to subscribe)。入口摩擦每增加一分,前端转化率就掉一截。正确的做法是:先零门槛拿到邮箱,在用户完成注册后的那一秒(此时他的参与意愿最高),再立刻跟进问问题。
- 铁律二:从你的「变现动作」倒推你该问哪两三个问题(Work Backwards)。 不要贪多问 20 个没用的字段。比如你是纽约本地媒体,知道用户在「大纽约地区」毫无意义,你要问的是具体的 Zip Code(邮编),这样布鲁克林办活动时才不会去骚扰住在新泽西的人。Dan 拿他自己的 Inbox Collective 举例:为了给新读者推荐最匹配的咨询或课程产品,他在欢迎流程里只需要问清三件事——① 你是哪类机构(出版商 / 非营利组织 / 个人创作者)?② 你现在用哪家发信平台(ESP)?③ 你未来半年最大的一个目标是什么? 只要拿到比如「个人创作者 + 正在用 Beehiiv + 想卖付费订阅」这三个标签,后续的自动化转化邮件就能一击即中。
围绕这两条铁律,Dan 和现场同行拆解了六种实测有效的战术:
- 欢迎问卷(Welcome Surveys,回收率高达 20%–50%):
用户刚输完邮箱点提交,立刻跳出或发出一封简短问卷,而且专问那些从外部数据库绝对买不到的「餐桌问题(Dinner-table questions)」:
- Autobody News(汽车维修行业媒体):领完免费资料后立刻追问姓名、车行名称与工种。
- Half Baked(创业点子 Newsletter):不仅问公司名,还直接问「以下哪句最符合你的现状?(还没打算创业 / 正在筹备 / 已经在做副业准备全职)」以及「你最感兴趣的创业方向是什么?」。
- Moby(投资理财 Newsletter):注册免费试用时问「你的财务目标是什么?」「你平时怎么做出投资决策?」。如果用户选了「喜欢深度数据研究」,后续向他推销付费版时,邮件就会重点展示图表、建模和 AI 分析工具。
- 嵌在欢迎邮件正文里的「一键打标」(In-Email 1-Click Tagging): 云计算圈很有名的 Last Week in AWS,在欢迎邮件里直接放三个超链接选项问读者:「为了给你发更相关的内容,告诉我你为什么订阅?① 我的 AWS 账单高得离谱;② 我想跟进行业动态;③ 我有个好产品想找你们推广。」用户只要随手点一下任何一个链接,后台自动打上标签(比如点①的直接进入降本咨询线索池),同时跳转到对应的精选文章页。
- 「传送带式」无限滚动追问(The Conveyor-Belt / Infinite-Scroll Quiz): 现场一位做免费资料下载(Lead Magnet)的同行分享了一个极聪明的微创新:当用户输入邮箱领取免费干货 PDF 后,千万别弹出「感谢订阅!」的结束页,而是直接弹出第一道单选题,答完立刻滑出第二道、第三道。因为用户不知道到底要答完几道题才能拿到那个免费资料,绝大部分人会顺着惯性一路点下去。Dan 补充说,新媒体 Puck 和 AI 简报 Deep View 都在用这招,Deep View 的注册后流程甚至塞了 14 到 15 道题,依然有大量用户老老实实一路点完。
- 静默式 B2B 数据补全(Silent Data Enrichment): 如果用户不填问卷怎么办?用 Apollo、Clay,或者直接用 Kit(原 ConvertKit)和 HubSpot 现在内置的数据补全功能。只要用户留了一个邮箱,系统后台自动去碰撞 LinkedIn 和公开企业库,静默补全他的姓名、公司、职位和所在地。Kit 甚至能做到:一旦检测到某家大公司的 C-suite 高管或某个大播客主播订阅了你的邮件列表,立刻发通知提醒你亲自去勾搭。
- 非传统的趣味价值交换(The Unconventional Ask): 怎么自然地拿到用户的年龄和生日?《华盛顿邮报》(The Washington Post)做了一个弹窗:「输入你的出生年月日,我们把你出生当天的《华盛顿邮报》头版找出来送给你。」 用户为了看自己出生那天世界发生了什么,开开心心地把精准生日交了出来;而《经济学人》(The Economist)则在话题勾选页上坦诚告诉读者「告诉我们你关心什么,这会直接决定我们编辑部接下来的选题投入」,用参与感换转化率。
- 清盘网站上被遗忘的表单(Form Audit): 把你网站上所有要填邮箱的地方——抽奖活动、读者来信、志愿者报名、评论区注册——全部拉出来盘点一遍。在每一个原本只收邮箱的表单上顺手加 1 到 2 个画像问题,积少成多。
五、四组白板脑暴实录:30 家美国媒体正在奏效的野路子,与最痛的真问题
Dan 讲完框架后,把屋里的 40 个人按 1 到 4 报数,随机拆成四个小组(其中一个幸运小组抢到了楼上的露天屋顶),分上下半场在巨幅白板纸上写下两张清单:上半场写「What's Working(我们正在做的、真正有效的招数)」,下半场写「What's Not Working / Challenges(最痛的瓶颈与失败教训)」,贴满整面玻璃窗和黑墙,然后轮流上台串讲,最后全员投票挑出最痛的五个问题当场会诊。
我把当天墙上贴出来的八张大白板(我散场前全拍了下来)和四个组的串讲、辩论,按逻辑完整梳理成下面这两份实战清单。
上半场:正在奏效的 12 个实战招数(What's Working)
1. 怎么把公域/匿名流量洗成自有第一方数据?
- Instagram 上的 ManyChat 自动私信裂变(转化率惊人): The Water Coolest 的 Tyler Morin 和 Dan 都在现场强烈安利了 ManyChat。做法是在 Instagram 发帖或短视频时说「在评论区回复某个关键词,我把完整报告/测试链接私信发你」,或者新粉丝一关注就自动触发一条私信问答。Tyler 的客户实测互动率高达 20%–30%;Dan 则透露,他服务的一家纽约大型出版商,光靠一条 ManyChat 自动化欢迎流,就能把 4% 的 Instagram 新增粉丝直接转化为 Newsletter 邮箱订阅者。Beehiiv 的 Francis Zierer 补充说,如果在 ManyChat 里发的不是生硬的「来订我的邮件」,而是一个好玩的「测测你是哪类人」小测验,转化率还会翻倍。
- 社交端发起、跳转 Typeform 收网的「每周新闻小测验」与半年期大调研: 我所在的第一组里,一位负责社交与播客的同行分享了他们的反常识发现:他们在 Newsletter 里放读者调研问卷,根本没几个人理;但放到 Instagram Stories 和播客里推,只有 6,000 到 7,000 粉丝的 IG 账号,每次半年期调研能收回 1,000 多份完整问卷!他们现在每周在 IG 上发第一道新闻测验题(保持中立话题),点完第一题自动跳转到 Typeform 完成剩余题目并留邮箱。
- 把问卷第一题直接嵌进邮件正文(《金融时报》FT 打法): 直接发一个「请花 5 分钟填一下读者问卷」的链接,点击率惨不忍睹。Financial Times 的做法是把第一道题(比如 1 到 5 分打分)直接做在 Newsletter 正文里,而且配好抽奖承诺。读者只要在邮件里随手点了一个分数,页面跳过去显示「你已经完成了 1/5,再点 4 下就能参加抽奖」,利用沉没成本把完卷率拉满。
- 去掉「伦敦上帝视角」、做成手机端游戏的 25 题长问卷(Quartz 案例): Charter 联合创始人 Jay Lauf 回忆他在 Quartz 当发行人时的经验:当年 Quartz 跟《金融时报》《经济学人》抢全球商业读者,但问卷回收率高得离谱,哪怕 25 道题的长问卷大家也抢着填,甚至还收到过读者写给问卷的「情书(unsolicited love letters)」。秘诀就两条:一是极致适配手机端、做成游戏化交互;二是彻底抛弃传统大媒体的「伦敦上帝口吻(Voice of God from London)」,用聪明、幽默、像朋友聊天一样的品牌语调去问问题。
- 性格/身份测试题(Quizzes & Trivia)依然是获客之王: Francis 举了通才社区 Generalist World 的例子:他们做了一个「测测你是哪种类型的通才(What type of generalist are you?)」的在线测试,做完题想看诊断结果必须输入邮箱——这一个测试带来的 Newsletter 订阅量,超过了他们做过的任何其他推广动作。
- 停留满 20 秒触发的「按月轮换实物抽奖弹窗」: 第二组的 Gavin Bechtold 和 Dave Gerlach 分享:不要干巴巴地弹「订阅我们的邮件」,而是当访客在网站停留满 20 秒时弹出「输入邮箱即可参与本月高尔夫球杆/球具抽奖」,而且每个月换一次奖品视觉,连老订阅者也可以填表重抽以补全最新画像。Francis 笑着现身说法:今年夏天为了抽 10 张世界杯决赛门票,他明知道中奖率接近零,还是心甘情愿给好几家公司交了超详细的个人数据,甚至花 5 美元开了平时根本不用的 Robinhood Gold 会员。
- 用「短周期快闪邮件(Pop-up / Short-run Newsletters)」降低承诺恐惧: 现在的读者有严重的「收件箱焦虑」,你让他订一份日更或周更邮件,他觉得是一辈子的负担;但如果你推的是「为期 5 天的迷你课程」或者「奥运会 / 世界杯 / NASA 阿耳忒弥斯登月倒计时专属快闪简报」,告诉他活动结束就停发(或者到时候再问他要不要转入常驻科学/体育简报),转化率会高出一大截。
- 短信(SMS)日更召回与 Open.video 视频捕获:
Tyler Morin 说他现在收集手机号是为了「防邮件之神哪天翻脸(CYA in case the email gods come down)」;而 Gavin 则给了一组实打实的案例:财经媒体 MarketBeat 甚至专门做了一个独立子站,每天只发一条「今日股票(Stock of the Day)」短信,靠 SMS 往网站导回了海量高价值流量;新闻简报 Join the Flyover 也跑通了同样的路子。另外针对 YouTube 观众没法导出邮箱的痛点,Gavin 提到了 Open.video(比如
videos.newspack.com在用的方案):在 YouTube 发预告切片做发现(Discovery),引导用户点回自家品牌的 Open.video 托管页看完整版并沉淀邮箱。
2. 怎么把攒下来的数据真正变成钱和留存?
- 抛弃总订阅数,改用「月独立打开频次(0 / 1 / 4 / 7+)」给受众分层: Beehiiv 的 Francis Zierer 分享了他最得意的一套指标:总订阅人数是个毫无意义的虚荣数字。他们平均每个月发 8 期 Newsletter,他只按「过去一个月独立打开过 >0 次、>1 次、>4 次、>7 次」把受众切成四层。在他的列表里,大约有 9.5 万人(占总列表的 24%)几乎期期必看(月打开 7 次以上)。上个月他的总打开人数(>0)掉了 2,500 人,但死忠粉(>7)反而涨了 2,500 人!拿着「我们有 24% 的读者打开每一封邮件」这个数字去见广告主,或者非营利媒体拿着这群人去募捐、做高客单价调研,说服力极强。
- 把「问卷里的一道题」当成高阶权益卖给大广告主: Gretchen Rubin Media 的 Amber 分享了一个全场拍案叫绝的销售实战:今年 7 月她在谈一个大额播客赞助商时,为了逼客户把预算往上提一档(Upgrade tier),她开出了一个零成本的筹码——「只要你今天签下高阶套餐,我下个月发全网读者调研时,允许你在问卷里塞一道你想问我们受众的专属问题(不拿邮箱,只拿统计洞察)。」 客户当场拍板成交,拿到一手市场调研数据后满意得不得了。
- 付费后立刻追问「你今天为什么买单?」以锁死首月留存: Memberful 的 Jen Matichuk 总结了平台上续费率最高的创作者经验:用户刷完卡成为付费会员的那一刻,立刻弹出一道简短的 Post-purchase survey(比如大学篮球媒体问「你最支持哪支球队?」,或者问「促成你今天付费的最核心原因是什么?」),然后用自动化标签立刻把对应的往期精华内容推给他,能极大降低首月退订率(Month-1 Churn)。
- 360° 画像、Click-Alike 外推与「下一步最佳动作(Next Best Action)」模型: 大媒体的玩法则更偏算法工程:比如前科技媒体 Protocol 当年直接借用销售团队没用完的 ZoomInfo 额度,把旗舰 Newsletter 的工作邮箱全量碰撞了一遍,不花一分钱调研就画出了完整的 B2B 读者职级画像;The Wall Street Journal、CNN(使用 Piano)等团队则把 CDP 里的第一方数据喂进倾向性模型(Propensity Model),在站内动态决定给当前用户弹什么窗口(是推 App 下载、推垂直 Newsletter、推捐款,还是在亚马逊 Prime Day 期间给高购买意向人群弹动态电商付费墙),甚至统计特定分群「超额点击(Over-indexed)」的文章类型,反过来指导编辑部定制约稿(Commissioning content)。
- Tyler Morin 的唱反调:别折腾问卷了,能买的直接买: 在大家热烈讨论怎么提高问卷回收率时,Tyler 举手泼了一盆冷水:「我提个反对意见——干脆别做问卷了。」 他的理由是,像家庭收入、职位、所在地这类基础人口统计学数据,现在通过 Apollo、Experian、TransUnion 等数据经纪商(Data Brokers)匹配的价格越来越便宜、质量越来越高;与其耗费读者的耐心去问这些能买到的字段,不如把仅有的提问机会留给那些「除了问本人绝对拿不到」的主观意图。
下半场:墙上更长的那张单子——全行业的集体焦虑(What's Not Working)
如果说上半场大家还在秀肌肉,下半场切到「What's Not Working(什么不管用 / 遇到的挑战)」时,四个组的白板纸瞬间被写得密密麻麻。Dan 看着贴满一整排窗户的纸条笑道:「每次都这样,痛点永远比办法长得多。」
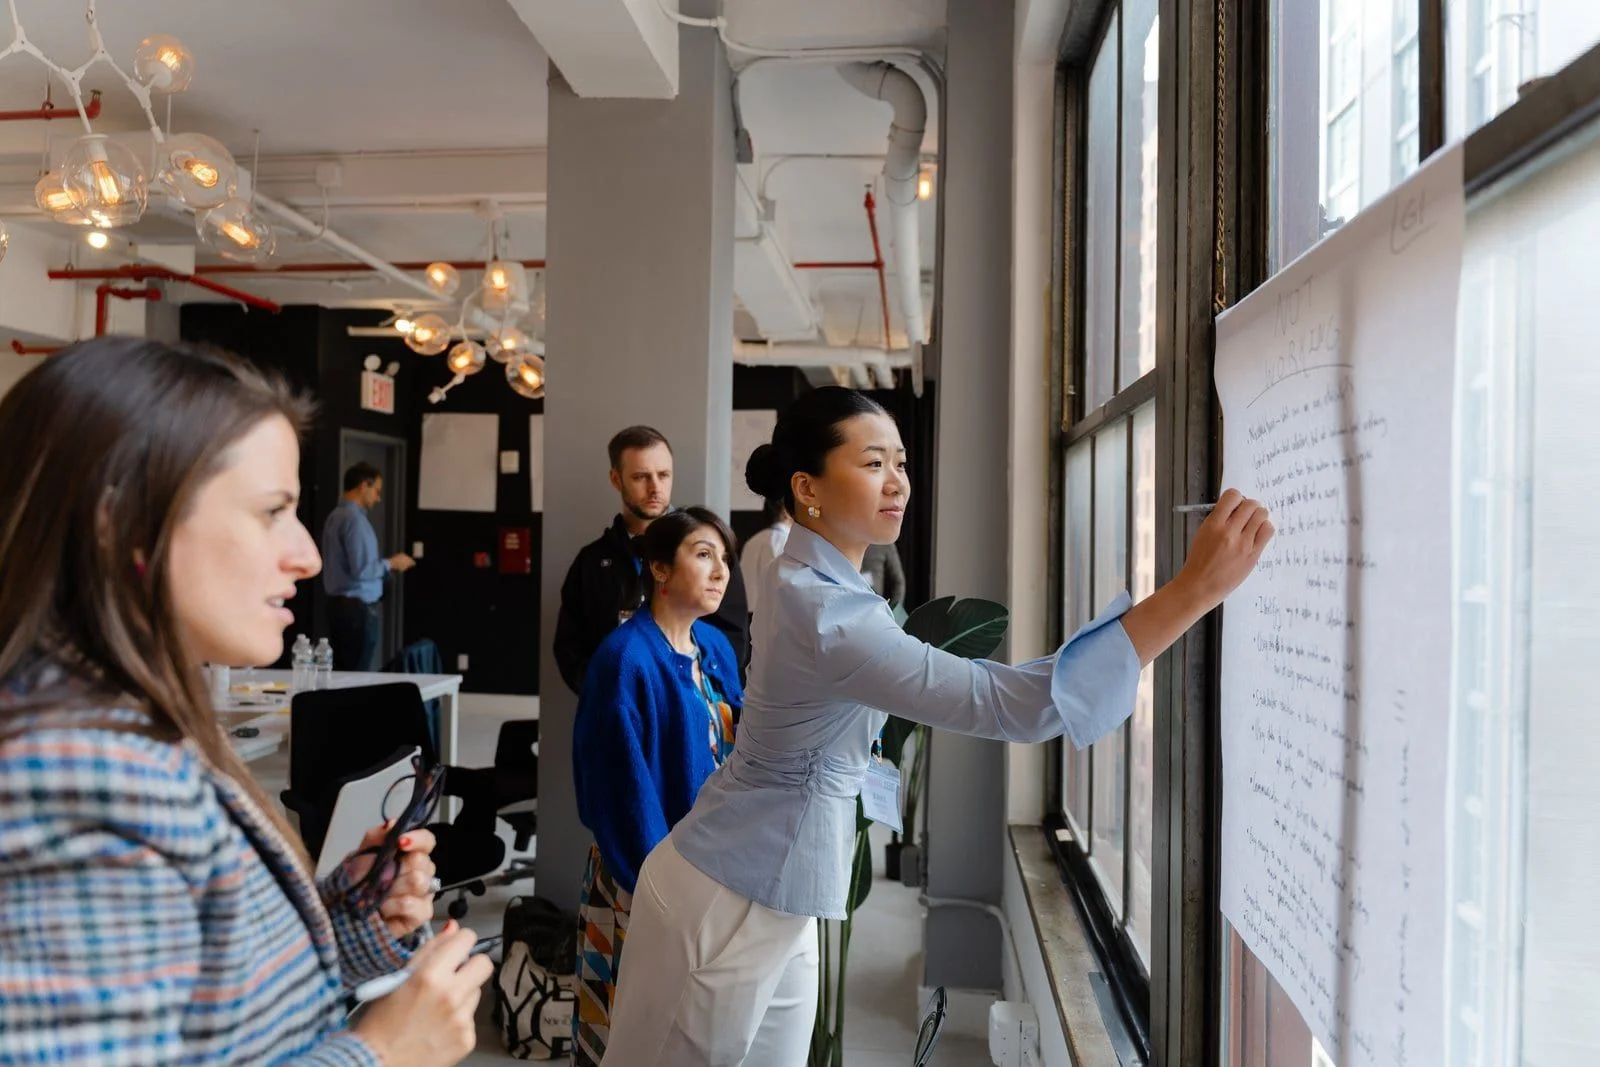
把四组白板上的几十条吐槽合在一起,今天美国媒体行业在第一方数据与变现上最痛的死结,集中在以下五点:
1. 收件箱生态的全面恶化(Inbox Collapse)
几乎所有依赖 Newsletter 的媒体都在抱怨同一件事:邮件越来越难打开了。
- 收件箱自动分类与 AI 摘要截流:我在组里提到,现在 Gmail、Apple Mail 的动态分类越来越激进,精心写的内容动辄被扔进 Promotions(推广)或 Updates 标签页;更要命的是,苹果和 Google 都在收件箱顶部加了 AI 邮件预览/摘要(AI Previews on Email),读者看一眼两句话的 AI 总结就觉得自己读过了,连点开的动作都没有。而且发件人信誉(Sender Reputation)惩罚极严,一旦你不加克制地给低活跃用户乱发邮件,打开率一掉,整个域名的送达率都会跟着陪葬。
- 机器点击(Bot Clicks/Opens)污染数据:企业防火墙和苹果隐私保护的自动预加载,导致后台看到的邮件打开率和链接点击率里掺了大量水分,很多团队苦恼于「手里的互动数据到底哪部分敢信」。
- 订阅疲劳(Subscription Fatigue)与标题党的反噬:读者收件箱早就满了,为了骗点击起个惊悚标题(Clickbait),赢了一次打开,却毁了长期的品牌信任。
2. AI 引发的信任危机与消费者的隐私防御战
这一条在第二组和我们组的讨论里擦出了很强的火花:
- 「我怀疑你是 AI 写的,所以我派我的 AI 去读」:我在组里分享了一个观察——现在不管你的文章是不是真人花心血写的,只要排版工整一点,读者第一反应都默认「这八成是 AI 生成的」,对文字内容的天然信任度在持续下滑;甚至在工作场景里,已经变成了「我用 AI 生成一份长文档扔给你,你再用你的 AI 把它总结成三句话来读」,中间那层文本彻底沦为走过场的泡沫。
- 每周都在收到的「自动化删库退订信」:消费者对隐私泄漏和「数据被卖给大公司或政府」的戒备心达到了历史高点。我跟同桌的人说,在 Open Exam Prep 上,我几乎每个星期都会收到要求「彻底删除我的账号和名下所有数据」的邮件——而且很多邮件根本不是用户自己写的,而是市面上专门帮用户批量清理全网数字足迹的自动化代理服务(Privacy Agent Services)代发的!更讽刺的是,为了合规,你在表单底下加的免责声明(Disclaimers:「我们承诺不出售您的数据」)越多,用户看着越害怕,反而越不敢填。
- AI 像素级抄袭:我问了同组一个问题:如果你的 Newsletter 或频道做得特别好,怎么防别人用 AI 1:1 复制你的风格和选题?我身边就有人专门干「用 AI 批量克隆热门 YouTube 频道」的生意。同组一位媒体人当场苦笑说,澳大利亚真有一家机构把他们旧版网站从设计到内容一字不落地全盘抄走,挂在公网上,他们却一点办法都没有。
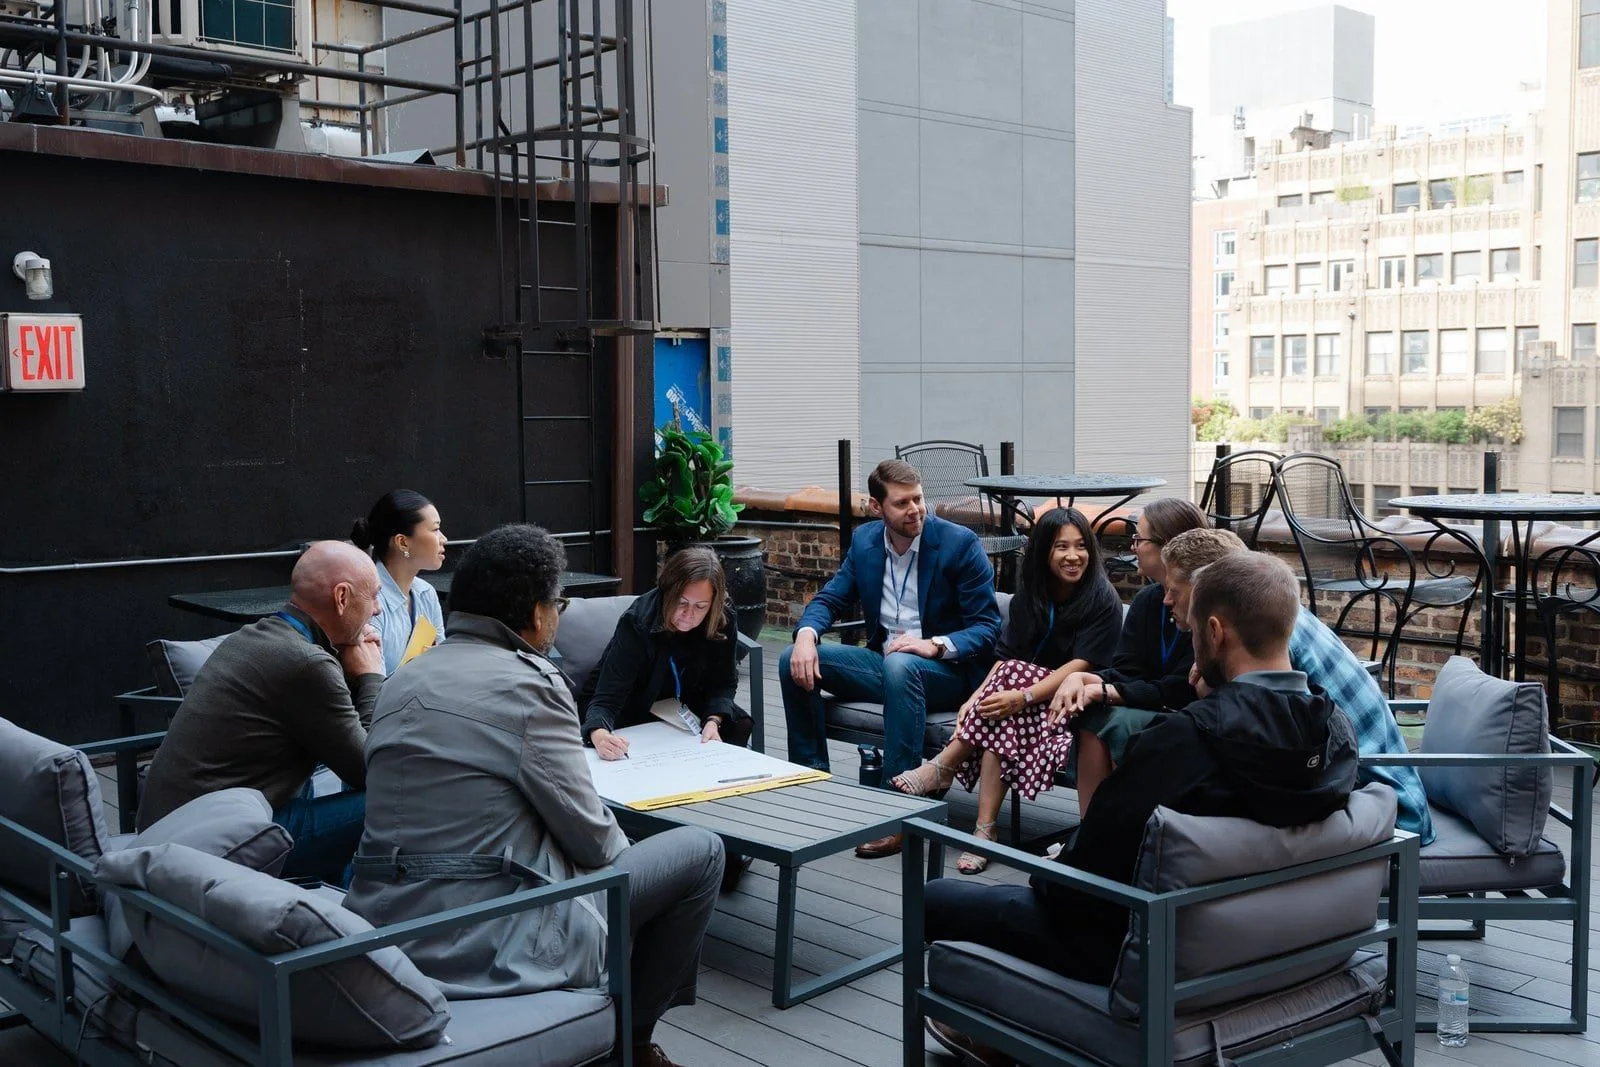
3. 「人口级收集很强,个体级行动很弱」(Good at Population-Level, Bad at Individual-Level)
第一组贴在窗上的白板(NOT WORKING — G1)写下了全天最深刻的一句总结:“Good at population-level collection, bad at individual-level actioning.”(擅长做群体层面的数据收集,却根本不会做个体层面的精准触达。)
我在组内讨论时特意追问了大家一个问题:「你们现在的瓶颈,到底是收不到足够的数据,还是收上来了不知道怎么用?」
大媒体的回答几乎一边倒地指向后者:他们有几百万人的问卷、有 Experian 匹配库、有漂亮的宏观受众画像看板,但这些数据除了拿去给广告销售做 PPT 卖赞助包之外,在产品端几乎是死水一潭。
为什么用不起来?我拿我以前在 Tubi 做推荐算法的经历打了个比方:对很多传统编辑部来说,算法和程序化推荐是一个让他们感到失控的「黑箱(Black box)」。白板上直白地写着编辑部的恐惧:「用数据指导人工定制内容(Bespoke content)很好,但害怕用程序化(Programmatic)——程序化会不会毁掉我们的编辑调性和公信力(Editorial integrity)?想针对不同分群做新内容产品,可如果不加人手(Without staffing increases),编辑部怎么忙得过来?」
4. 跨平台数据孤岛与「受众全在社媒和 LLM 里,WTF?!」
第三组的白板纸上,用大号马克笔写着两行让全场会心大笑又倍感无奈的话:
biggest audiences are on social — it's hard to get them off. no real data(最大的受众群都在社交平台上——极难把他们导出来,手里没有任何真正的个人数据。)audience is on LLMs... WTF?! — how often are we being cited? use cases... (equivalent of keywords)(受众现在全在大模型里……搞什么鬼?!我们到底被引用了多少次?完全没有类似传统 SEO 关键词那样的后台数据!)
汇报人 Vivian / R 在台上解释说:今天越来越多读者是通过 ChatGPT、Claude 或 Perplexity 接触到媒体品牌的,但在大模型这个黑盒渠道里,出版商既拿不到点击,也看不到类似 Google Search Console 的搜索词报表,完全不知道自己的内容是怎么被大模型咀嚼、拼接和消费的。而在机构内部,哪怕是同一家媒体集团,网站、播客、App、线下活动、十几个子品牌的 ESP 和 DSP 各用各的系统,连跟合作伙伴对数都在鸡同鸭讲。
六、茶歇与 Capizzi 披萨晚宴:从 Pure Global 的「全员只发邮件」,聊到 Tubi 的 B 级片与 AI 音乐的坑
下午四点半,在最后的全场总结环节,Dan 请三个志愿者各说一件「回办公室后未来两周内立刻要落地的动作」。
第一个举手的是 Beehiiv 的 Francis:「我要开始教我的客户把问卷里的单道题卖给赞助商。」 第二个举手的是 Charter 联合创始人、前 Quartz 与《大西洋月刊》发行人 Jay Lauf。他看着我这边说:
「我最喜欢今天早上一开场(陈然)讲的那个点子——用 AI 去创造有机的互动(Organic interaction),让用户在第一次访问的会话里,因为要跟 AI 交互而顺理成章地注册、留下数据,而不是给所有人弹一个冷冰冰的静态注册框。这对我启发很大。」
散会后,一群人穿过曼哈顿中城繁忙的街区,走进第九大道(靠近 41 街)那家叫 Capizzi 的意大利小餐馆。店里有一座正宗的砖砌烤炉,桌上摆满了松露布拉塔披萨、意式辣香肠披萨和气泡水。
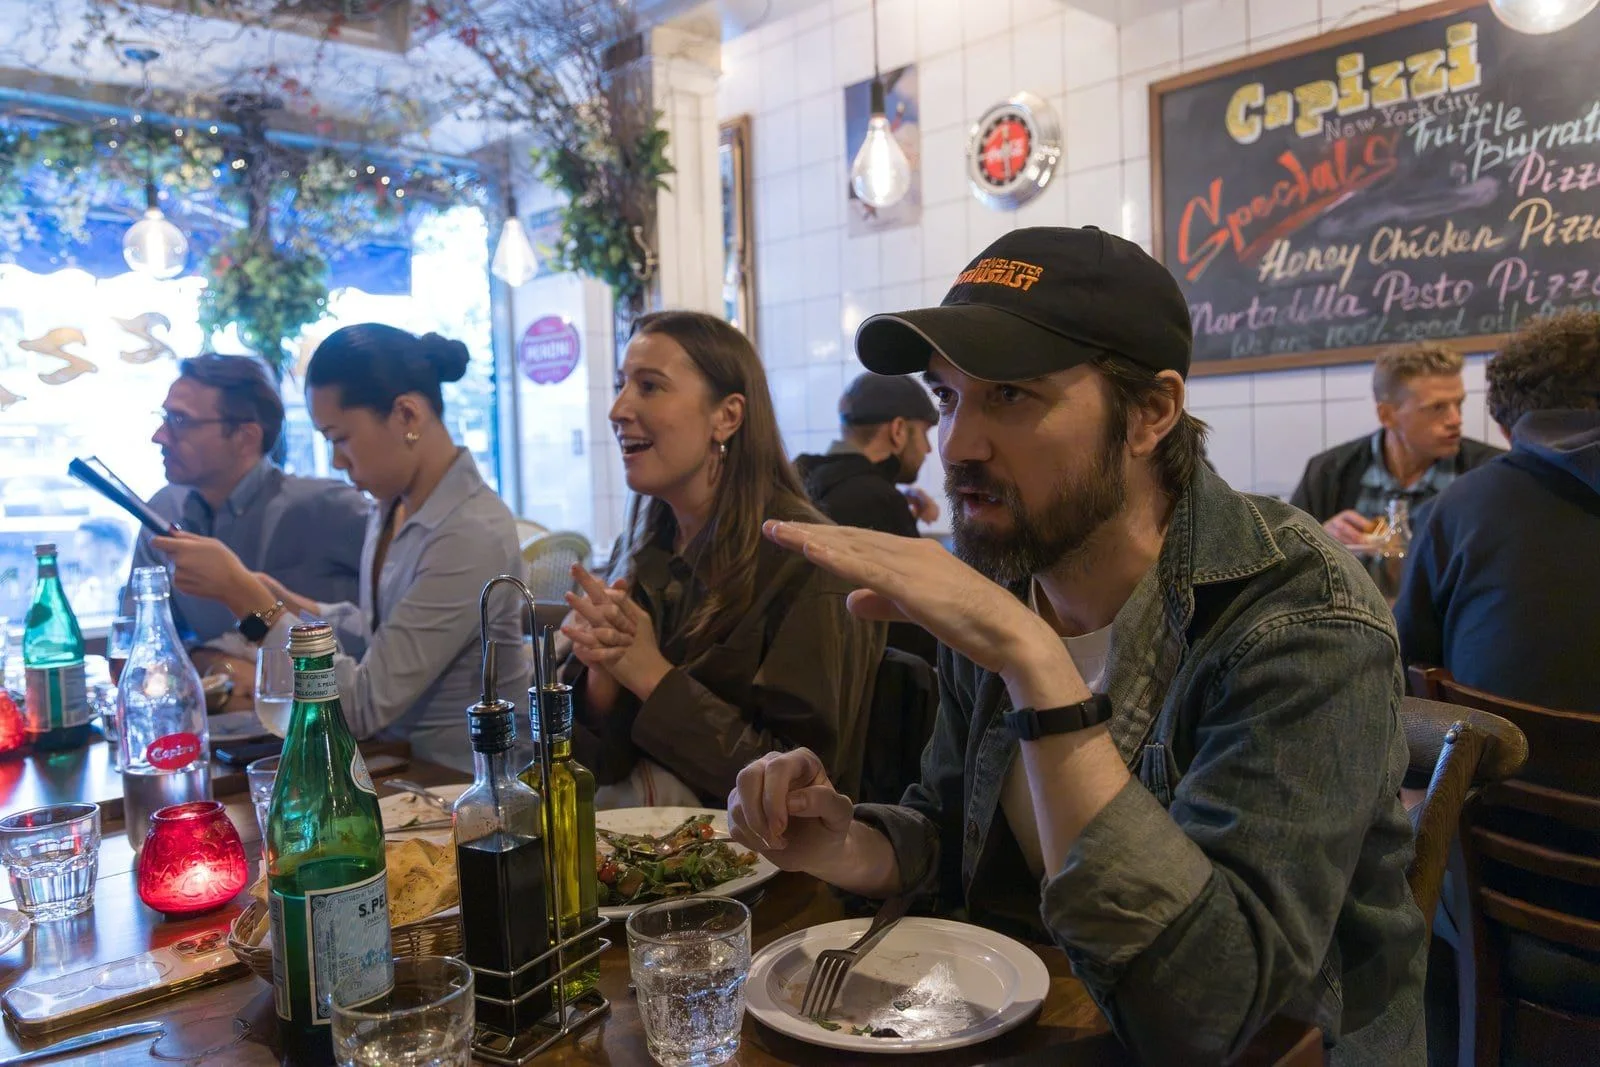
白天的茶歇、午餐,加上晚上在 Capizzi 的这顿饭,我和周围的媒体人、Ezoic 团队聊了很多台上没展开的硬核话题,有几段特别值得记一笔。
1. 为什么我在公司里取消了同步会议,规定「所有人找我只能发邮件」?
白天茶歇和午饭时,好几个人好奇地问我:你既然全职在 Pure Global 当 CTO,怎么可能还有精力一个人维护一万个考试的网站?你们公司内部到底是怎么用 AI 的?
我跟他们讲了我在《每家公司都既是产品公司,又是媒体公司》里提过的 Pure Global 转型:我们帮全球医疗器械公司做各国监管注册(比如极其繁琐的巴西 ANVISA 注册),2025 年我加入推进全面 AI 转型后,直接裁掉了所有的项目经理(PM),彻底砍掉中间传话层,把交付效率提了大约 10 倍。以前巴西等国家的注册文档积压如山,现在 AI 把审核与文档生成全包了,交付完全不再是瓶颈,公司唯一的瓶颈变成了「客户从哪来」。
而在工作方式上,我在公司立了一条听起来很极端的规矩:取消日常同步会议,要求所有人不要直接找我说话或发即时消息,找我一律发邮件(Email)。
为什么在 2026 年我反而觉得邮件(Email)是最被低估的 AI 入口?
- 邮箱地址是天然的全局唯一身份标识(Unique Identifier):用户在网页聊天框(Web UI)里平均停留不到一分钟就关掉了,你很难跨平台追踪他;但每个人的邮箱地址是固定的。
- 邮件天生是异步的(Asynchronous),能承载附件和深度研究:在网页聊天窗口里,AI 如果思考超过 10 秒钟,用户就嫌慢关页面了;但如果是发邮件,用户天然预期「过 10 到 20 分钟甚至两小时收到回复都很正常」。这就给了背后的 AI Agent 充足的时间去翻阅全部历史文档、跑完深度研究(Deep Research)、生成带附件的完整方案再回信。
- 不写前端 UI,直接给 AI Bot 分配一个邮箱地址:我们在内部尝试过做各种花哨的网页工具,后来发现最高效的交互界面根本不需要写 UI——直接给 AI Agent 开一个公司邮箱地址,让员工和客户把需求、合同或报错直接发邮件(或者抄送)给这个 AI 邮箱。如果团队成员不先问 AI 就跑来问我,而 AI 回答不上来,那就说明我们的 AI 知识库基建有漏洞,直接去补基建,而不是开会。
2. 披萨桌上的 Tubi 往事:从跟编辑部吵架,到《Plug Love》和《Titanic 666》
在 Capizzi 坐定等披萨的时候,同桌的媒体人问起我在 Tubi 的经历:「我早上才知道你以前在 Tubi 工作过,你们当年到底是怎么做起来的?」
我给他们讲了 2017 年我作为第一位数据分析工程师加入 Tubi 时的故事。 我刚进 Tubi 的时候,整个 App 首页的电影排序百分之百靠人工编辑手排,完全没有个性化推荐。我进去以后带着数据跟产品团队、内容采购团队大吵了一架,强推算法个性化。内容团队当时极其抵触——因为他们都是好莱坞科班出身的影视人,觉得自己最懂什么是好电影。
结果个性化算法一上线,跑出来的数据把所有人都看傻了: 在 Netflix 和主流院线根本没人看的一部黑人低成本独立电影 《Plug Love》,还有真人秀 《Little Women: Atlanta》,在 Tubi 上的观看时长高得惊人!当时团队里根本没人能解释为什么这部片子会爆,以至于后来在 Tubi 内部,“Plug Love” 成了我们的一个专有黑话——凡是主流精英完全无法理解、但底层数据爆表的神片,我们都叫它 “a Plug Love thing”。
这件事教会了我一辈子受用的商业常识:主流好莱坞和纽约媒体精英视野之外,存在着极其庞大的、完全没有被好好服务过的长尾受众(Underserved long-tail audiences)——在流媒体里,这群人看的是黑人电影、独立小片和 B 级恐怖片。后来 Tubi 自制原创电影(Tubi Originals)时,甚至直接把平台上数据最好的热门长尾元素像搭积木一样拼在一起,拍出了像 《Titanic 666》(泰坦尼克号惊悚 + 女巫超自然恐怖)这种听名字就让人忍俊不禁、但观众互动数据好到爆棚的片子。靠着这套长尾加算法逻辑,Tubi 一路涨到超过 1.1 亿月活,总观看时长超越 HBO 和 Disney+,2020 年被福克斯(Fox)高价收购,拿下了体育赛事甚至超级碗(Super Bowl)直播。
今天我做 Open Exam Prep,底层逻辑跟当年的 Tubi 一模一样:不去跟大教育公司抢那 10 个头部考试,而是去服务那一万个没人管的「考试界《Plug Love》」。
3. 体育博彩的狂飙、Letterland 的「精准 200 人」法则,与我踩过的 AI 音乐坑
酒过三巡,桌上的话题越来越放飞,有三个片段特别有意思:
- 美国媒体圈的「钱包 vs. 良心」:体育博彩与预测市场: 桌上好几位做体育和大众媒体的同行聊起了这几年在美国疯长的体育博彩(DraftKings、BetMGM)和预测市场(Prediction Markets)。有人直言,现在的预测市场 90% 的交易量本质上就是披着金融外衣的体育博彩;有人提到餐厅服务员在世界杯期间随手下 500 美元的串关(Parlay),还有人说身边的朋友现在坐在沙发上刷手机,打开的已经不是《糖果传奇》(Candy Crush),而是在 DraftKings 上直接摇老虎机。一位同行坦言,他们机构今年刚忍痛拒掉了一笔金额巨大的博彩赞助,原话是「那是一场钱包和良心的较量(Wallet vs. Conscience),这东西从 0 到 100 失控得太快,对年轻男性的杀伤力太大了」。
- Tyler Morin 的《Letterland Live》:哪怕只有 1,000 次播放,只要看的人是对的 200 个老板就够了: 聊到 B2B 媒体怎么变现时,The Water Coolest 的 Tyler 分享了他们每周三直播的行业播客 Letterland Live。如果按大众媒体的流量逻辑看,这档节目全平台每期只有大约 1,000 次观看,按 CPM 卖贴片广告连塞牙缝都不够。但神奇的是,这 1,000 个观众里,精准覆盖了全美 Newsletter 行业里最核心的 200 到 300 个决策者。因为受众极其纯粹,增长工具 SparkLoop 直接包下了赞助,节目还源源不断地给他们带来高客单价的企业咨询线索;同时他们每天发 Letterland Brief,把直播切成无数短视频「淹没信息流(Flood the feed)」,连《华尔街日报》的记者都因此主动找上门来采访他们。
- 散场后的实话实说:我为什么停掉了 AI 音乐副业? 从餐厅出来往外走的时候,我和 Ezoic 的伙伴聊到了「网赚快钱(Quick money)」的生命周期——从早年的加密货币,到现在的各种 AI 副业课(YouTube 现在已经在严打承诺具体副业收入的视频了,网上晒出来的后台收入截图十有八九是改网页源码伪造的)。 我跟他们坦白了我自己在 AI 音乐上踩过的大坑(这段经历我在月球大叔的播客访谈里也简单提过,细节在《如何使用 AI 制作音乐视频》和我的音乐收入看板里都能看到): 我用 AI 做了不少歌,但很快发现音乐行业是一个完全没有「免费长尾 SEO 流量」的世界。在 Google 上有人会搜冷门考试题,但在 Spotify 上没人会去搜一首从未听过的歌。为了冷启动,我去投了 Meta(Instagram/Facebook)广告,算下来 ROI 只有 0.1 左右(花 1 块钱只能赚回 1 毛钱流媒体分账),投得越多亏得越惨;如果去找市面上那些号称帮你做歌单推广的机构,他们背后全是用机器人(Bots)刷播放量,很快就会被 Spotify 的反作弊算法识别并清零;而如果你想模仿老歌或翻唱,音乐行业的版权检测(Content ID)又是全世界最严密的。所以我最后得出的结论是:在音乐这个赛道里,那些教你「靠 AI 音乐月入过万」的人,唯一的赚钱方式就是赚你的学费。 对方听完深表赞同,顺带聊到了 Cloudflare 最近推的 HTTP 402 按抓取付费协议(Pay-per-crawl)——理论上让 AI 爬虫每次抓取网站内容时付费,但我实话实说,到现在为止我还没听说身边有哪个独立站长真的靠 402 协议收到过钱;相比之下,把移动端占了 40% 份额的激励广告(Rewarded Ads,看一段广告解锁一次功能或积分)搬到网页工具和桌面端,才是眼下看得见摸得着的真金白银。
七、走出曼哈顿 Loft 的四点复盘:一个工程师在媒体圈看到的代差与机会
第二天一早我赶飞机回旧金山。在飞机上翻看手机里拍的那八张白板照片,再对比这群美国顶级媒体人的日常,我有四个非常强烈的感受。
1. 传统媒体的瓶颈在「组织包袱与系统割裂」,不在点子
下午收尾讨论「面对 37 个新点子怎么排优先级」时,来自各大媒体的同行讨论的都是:怎么去跟其它部门沟通、怎么走层层审批(Levels of approval)、怎么在十几个割裂的 ESP 和 DSP 之间对数。Dan 甚至得教大家一个心理技巧:「挑一件 4 分钟就能改完的小事,在下午两点开下一场会之前逼自己点完鼠标。」
而在下午两点半的茶歇时,我对着录音笔给自己留的备忘是:「今天学到的这一整套 User Ladder 和问卷点子,我这个周末就让 AI 写代码上线,最迟下周末前全部跑通。」 在午饭时跟 Ezoic 团队聊天,我说了一句让他们很感慨的话:大媒体公司哪怕看到一个再好的新功能,内部法务、编辑、工程走完流程也要大半年;而我因为没有历史代码包袱、没有员工、没有跨部门会议,Ezoic 只要给我发邮件推一个新功能,我当天晚上就能把文档丢给 AI 接入上线。
在 AI 时代,「知道该做什么」的门槛正在被抹平,真正的护城河是从听到一个点子到代码上线验证的时钟周期(Clock speed)。一个懂产品的工程师加 AI,在执行速度上对传统媒体组织是降维打击。
2. 从「分群(Segmentation)」到「千人千面(N=1 Personalization)」的认知代差
整场工作坊听下来,哪怕是全美最先进的 Newsletter 和媒体团队,今天在第一方数据上的最高理想,依然停留在「做好 3 到 5 个受众分群(Segmentation)」——比如按行业分三类、按打开频次分四档。
他们之所以不敢往「真正的千人千面(N=1)」去想,是因为在人类编辑主导的成本结构里,为 10 万个读者写 10 万封不同的邮件是天方夜谭。但如果你站在大模型工程的视角看,当 Token 成本跌破临界点之后,基于每个用户独一无二的错题记录、点击轨迹和问答上下文,实时生成一封只属于他一个人的复习邮件或产品推荐,在工程上已经完全可行,而且在广告 + 联盟营销的复合变现下是正 ROI 的。
白板上写的那句「擅长群体收集,不擅长个体行动」,在传统人力组织里是无解的死结,但在 AI 原生架构里,恰恰是最大的红利窗口。
3. 「静态内容已死,互动即数据」被全场验证
为什么前 Quartz 与《大西洋月刊》发行人 Jay Lauf 在全天结束时,会专门提起我早上讲的「AI 交互引导注册」? 因为今天所有媒体都面临同一个悖论:你越是在静态文章后面弹问卷、弹注册墙,读者越反感、越流失;而在纯信息内容被 ChatGPT 和 Google AI Overview 截流的今天,静态页面的停留时长本身就在萎缩。
唯一的破局点,就是把内容变成工具,把阅读变成互动。无论是我做的在线刷题 + AI 拆解,还是同行们验证有效的性格测验(Quizzes)、高交互小游戏、Instagram 上的 ManyChat 自动问答,底层逻辑都是相通的:不要等用户消费完内容再去向他乞讨数据;要让「输入数据、与系统/AI 互动」本身成为用户消费内容的过程。
4. 算清 LTV,才能抓准下一代媒介(比如 AI 视频)的拐点
在下午的茶歇里,我跟几位同行聊到了我一直在算的一笔账:什么时候该大规模上视频内容? 大家都知道视频的互动率和信任感最高——比如在邀请用户填问卷或解释一道难题时,如果在旁边放一段真人或高拟真出镜讲解视频,转化率一定远高于冷冰冰的文字。但大规模做视频很贵。我研究了一圈 AI 视频生成的成本结构,发现现在真正贵的已经不是生成画面或克隆声音了,而是精准的对口型(Lip-sync alignment)。对我们做 AI 的人来说,一眼能看出哪个视频是 AI 生成的;但对普通大众用户来说,他们其实根本不在乎是不是 AI,只要口型自然、讲得有用就行。
什么时候这笔账能算平?核心就在于 Ezoic 正在推的那个指标——单用户 LTV(生命周期价值)。 只要通过第一方登录把用户的跨会话价值算清楚,知道一个实名备考用户从第一次进站、到反复刷题、再到打开个性化邮件,全周期到底能贡献多少广告和联盟收入;一旦这个 LTV 跨过单条 AI 视频(或更强推理模型)的生成成本线,就是一键开启全站十万个长尾页面批量视频化的拐点。
走出曼哈顿那间 Loft 的时候,我想起开场时《新泽西月刊》发行人说的那句「我们不能再像以前那样相信 Google 了」。其实换个角度看,旧流量的退潮,恰恰让每一个留下来的真实用户变得比过去贵重了三倍——前提是,你得先用真正的价值交换,让他们愿意告诉你他是谁。
继续阅读
全部内容
做内容站,赚广告钱:我的被动收入打法
我在《AI 时代的真优先级》里写过,拿到 AI 以后,真正的优先级只有三步: 1. 靠 AI 赚到被动收入,解决钱从哪里来的问题; 2. 研究清楚人和钱的关系; 3. 去创造自己想要的事业和生活。 前面两步都解决了,你才能真正去追求自己想要的人生。 第一步是地基。我有 CFP(注册理财规划师)执照,跟无数人深度聊过钱的...
AI 会永远找到方法让你开心
我现在和 AI 聊天,最怕的不是它说错。 最怕的是它说得太顺了。 你随手抛一个想法,它很快就能接住。你说一个还没想明白的商业判断,它能帮你补出三层逻辑、五个案例、一个标题和一段很像结论的总结。你本来只是想试探一下,最后反而被它说服:这件事好像真的很深刻。 这就是我最近越来越强烈的不适感。 以前我以为 AI 的危险主要是...
AI 时代的真优先级
AI 可太热闹了。 公开世界里的 AI 永远在加速:新模型、新框架、新工作流,几句话做完一个网站,几分钟生成一套 PPT。社交媒体上人人都在高喊 10X、100X。 可一旦离开发布会和社交媒体,走进真实的交付现场、客户对话和商业结果,速度忽然就慢了。代码要维护,错误要有人兜底,客户不会因为你用了 AI 就多付一分钱;那...