2026 年底我想要的真正的 AI

2026 年 11 月,几天之内我连续刷到几个让人坐直身子的发布:Vercel 推出了实验性的 Vercel Board,把多 Agent 协同抽成一套无头消息板与任务租约原语;此前不久,DeepSeek 开源了 dsh-superagent 研究原型,直面单线程 Agent 的全双工改造;再往前还有 OpenAI 的后台编码调度规范 Symphony,以及社区里涌现的零人公司编排器。
我盯着这些项目看了一整晚,心里既兴奋又叹气。兴奋在于行业终于不再只卷模型跑分,开始啃那层把人、业务和代码组织起来的底层框架——我甚至还没想好它该叫 AI Stack、Agent Harness,还是 AI-Native 的公司操作系统。叹气则是因为过去一年,我在自己的真实业务和工程里反复搭建、反复推翻,撞上的全是同一堵墙。我在《冥想和正念,救不了 AI 时代的打工人》里写过一线工程师同时盯三四个 Agent 产生的认知过载,轮到自己拿 AI 经营多方协作的真实系统时,那种别扭感只会更强。模型早就不缺智商了,2026 年底真正折磨我们的,是外部客户、第三方协作者、内部同事、核心开发者和一群 AI Agent 之间,怎样在一套系统里自然运转。
这篇文章想把过去一年我自己踩出来的实践、反复卡死的抽象难题,以及对照当下开源生态后看到的真实缺口摊开讲清楚,也顺手回答一个问题:我想要的这套 AI 环境,2027 年能到吗?
为什么现有的 AI 工程做法总让人觉得不优雅
把大模型塞进老系统,或者在本地挂几个定时脚本跑 Coding Agent,看起来很热闹,真放进多人协作的生产环境跑上三个月,四道结构性裂缝立刻露出来。
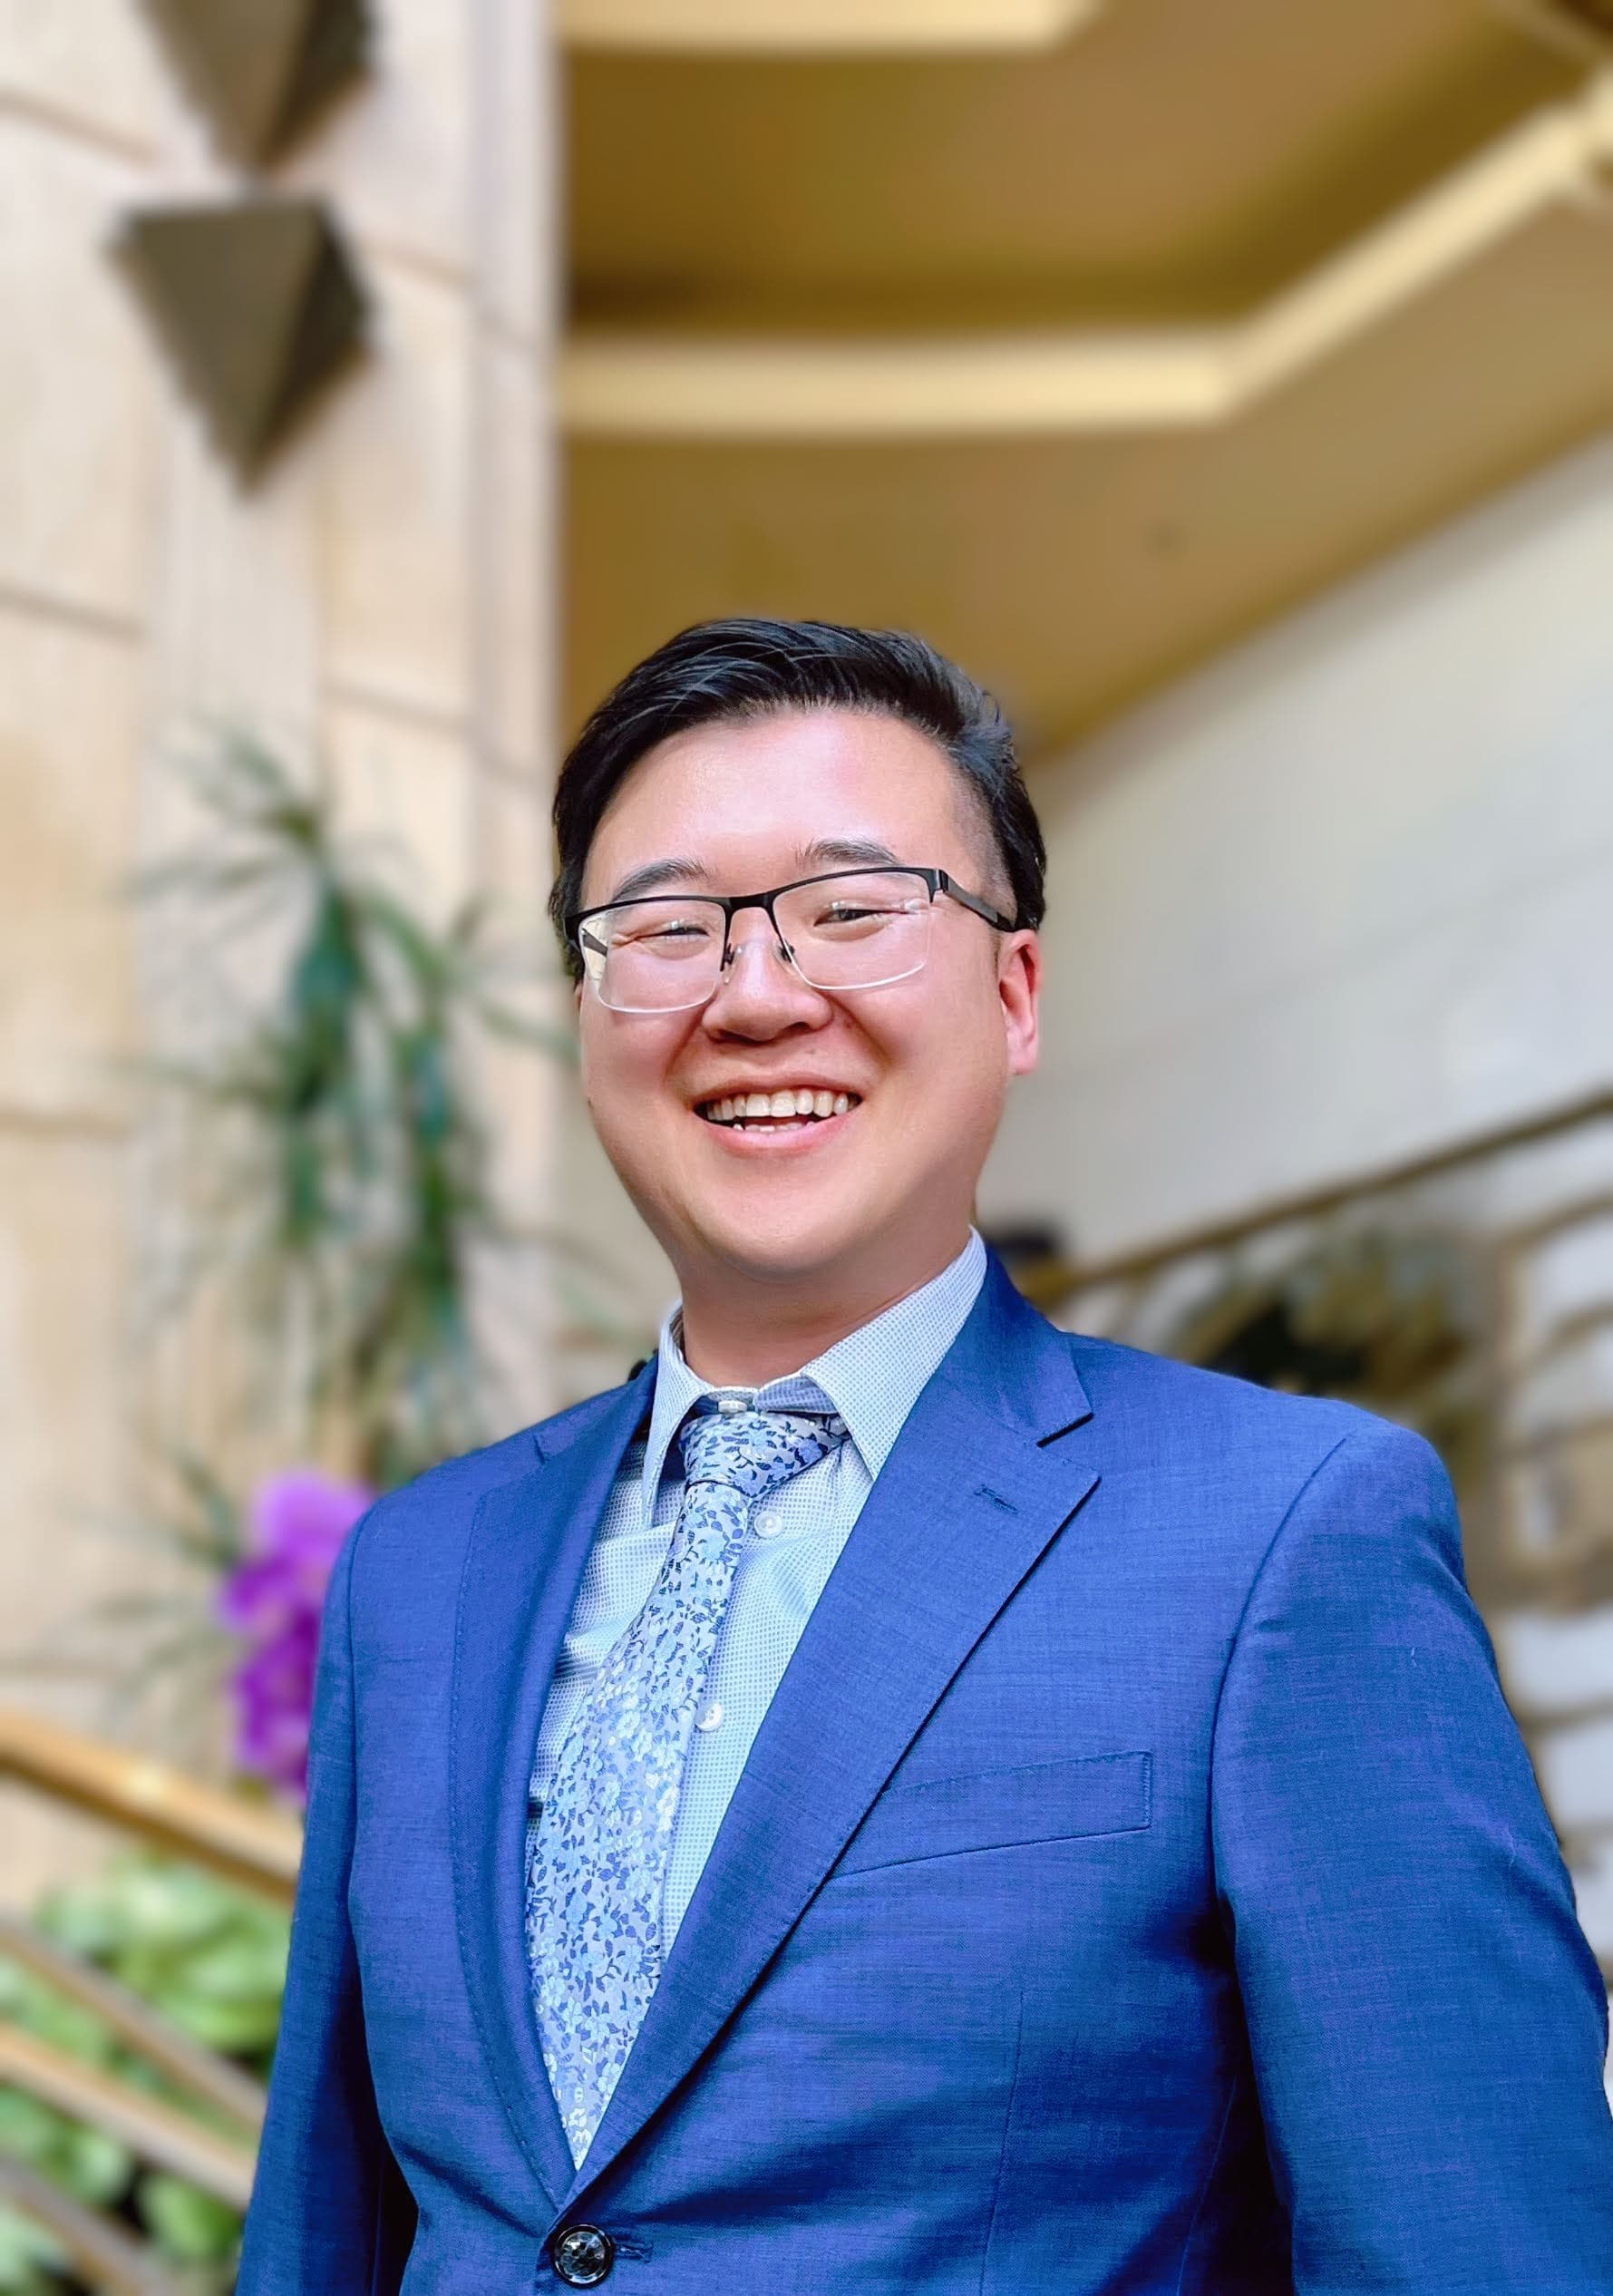
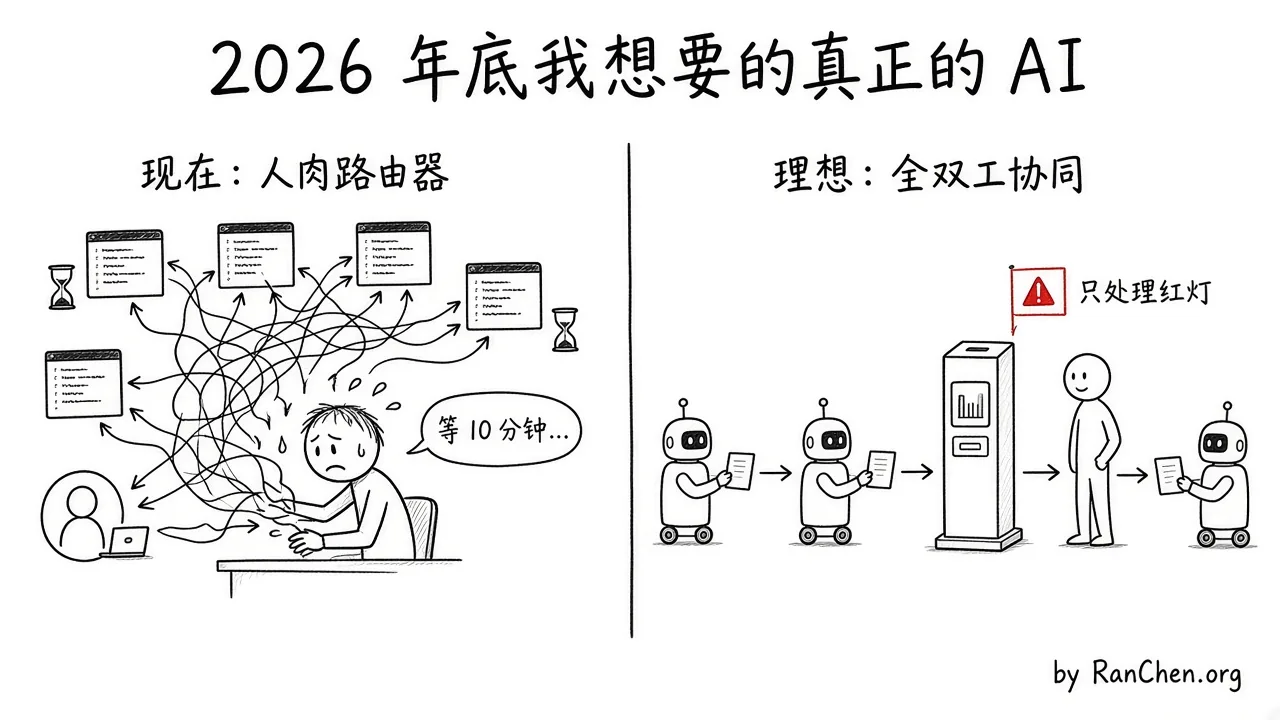
第一道裂缝,是半双工交互带来的注意力崩塌。今天绝大多数 Agent 仍是半双工(Half-Duplex)的:人发出一段指令,Agent 锁死进入工具循环,跑上五到十五分钟。这期间系统对外部世界完全失聪。客户补了新要求、构建弹了异常、你中途想调方向,全都没法平滑插话,只能干等或粗暴中止重来。手里并发十件事,人就得开十个终端窗口来回切上下文,沦为在窗口间递纸条的人肉路由器。
第二道裂缝,是前台交付与后台协作的断层。对外给客户看的界面必须干净、克制、零泄密,只暴露进度、预览和需要对方拍板的那一步;但后台的开发者与 AI 需要排查报错、拆解子任务、跟踪外部卡点。因为系统里没有原生的后台协作空间,内部状态被迫泄漏到各种丑陋的旁路:越写越长的本地 state.json、靠 pull 和 push 搬运的临时目录,以及靠定时任务全量扫库算指纹的胶水脚本。前端十来秒轮询一次,后台十五分钟巡检一次,本质还是上个时代的异步留言板。
第三道裂缝很少在公开发表物里被细算,却是最硬的工程约束:本地包月订阅与云端按量 API 之间的成本剪刀差。严肃的工程或研究型 Agent 任务,跨十几个仓库读上下文、反复编译修错,单次消耗几十万到上百万 Token 稀松平常。跑在本地常开机器上吃包月 Subscription,边际成本几乎为零,还天然坐拥大仓库和私有数据;一旦为了追求“全员在线”把重型推理全搬上云烧按量 API,月账单立刻涨出十到三十倍,还要忍受冷启动克隆和上下文截断。大多数云端框架默认算力全走 API,在真实账本上根本站不住脚。
第四道裂缝来自封闭 SaaS 的拼装幻觉。硅谷当下流行拿 Linear 接研发和 Agent,外头套一层客户反馈门户,旁边再挂一套 HubSpot 这类传统 CRM。可真要经营多业务实体时,线索、客户档案、项目阶段、第三方外协和 AI 交付物底层本就属于同一张实体图。Linear 终究偏向研发 To-Do 列表,不做多租户白标门户,也装不下可插拔的 CRM 与自定义业务模块;传统 CRM 更是封闭孤岛。拿四五套 SaaS 靠 Webhook 互相粘在一起,AI 永远隔着残缺接口做二等公民,数据漂移迟早把整套流程拖垮。
单点模型已经能写出很像样的代码和报告,可承载它们的组织与运行时架构,依然停留在聊天窗口、定时脚本和孤岛 SaaS 的缝合期。
过去一年,我在四块实验田里摸出的四个器官
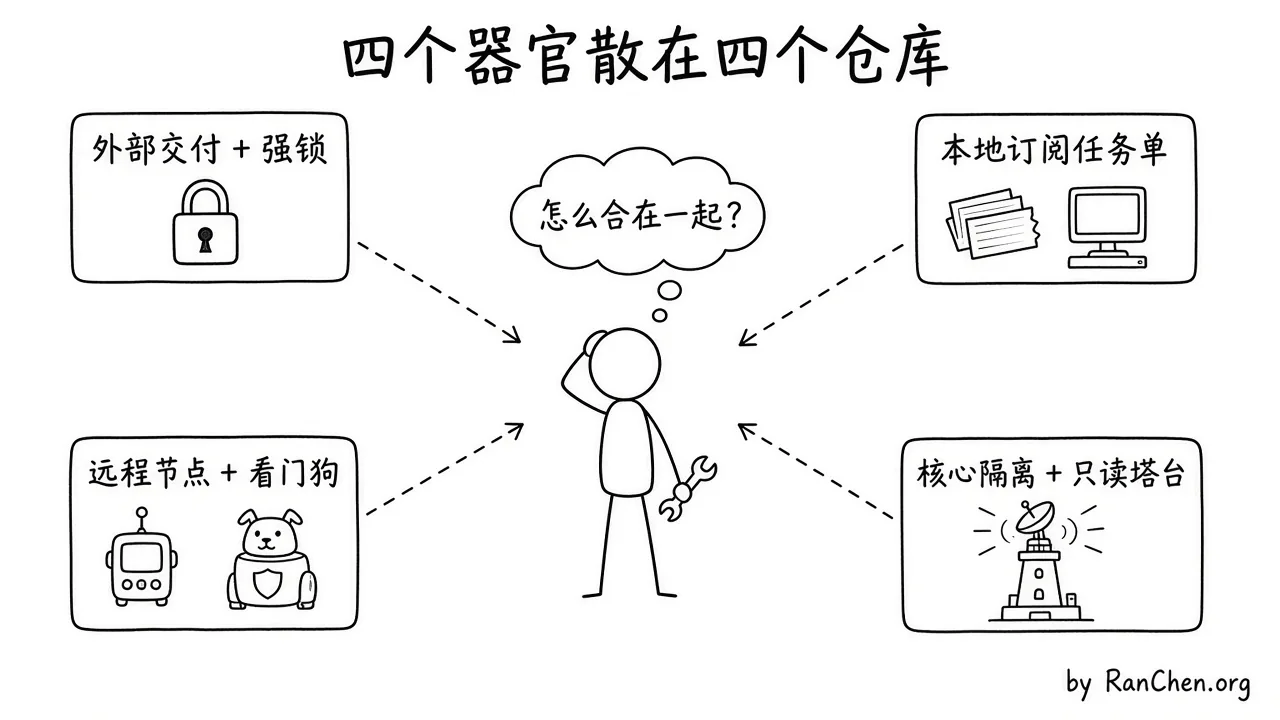
过去一年多,我针对四类形态迥异的真实业务,分别搭了四套独立系统。很长一段时间我总懊恼自己像在原地重复造轮子,直到最近把这四套架构横向排开复盘,才发现我其实把一台完整机器的四个核心器官分别练到了生产可用,只是它们至今还散落在不同的代码库里。
第一块实验田,是一套多租户外部交付门户与内容审稿系统。在这里我摸清了外部协作面的边界:客户端所有沟通收敛进按对象挂载的统一消息流,批准本身就是对话里的结构化回答;底层守住强关系型不变量,用数据库行级锁和版本号哈希绑定每一次修改与审批,并靠一个纯函数从存储事实实时推导出“现在球在谁手上”,杜绝并发改稿与误发布。
第二块实验田,是一套跑在本地常开主机上的研究与外联 CRM 流水线。为了兼顾高频改规则和零云端模型费,系统把所有步骤严格分成三类:确定性的程序、交给模型的 AI 步骤,以及只做放行判断的关卡(Gate),显式声明副作用,并用内存工作区支持全链路 dry-run 彩排。核心突破是把模型调用解耦成“内容寻址的异步任务单”——带输入、提示词版本哈希和严格 JSON Schema;大批量粗活交给常开主机上 7×24 运转的廉价订阅 Worker,无风险项自动采纳,带异常标记的和高阶判断留给强模型与人类复核。数据层把“共享行业实体知识”和“按客户隔离的跟进记录”彻底劈开,几乎零按次 API 费用,严谨度却极高。
第三块实验田,是一个服务我个人的多通道常驻代理。日常即时通讯与入站邮件按真实身份鉴权后实时唤醒代理,耗时任务异步委派给独立后台会话,不阻塞主对话;云端只留轻量任务队列,内网常开机器通过出站 HTTPS 主动拉单执行,能跑一次性命令,也能接管持久终端会话操作本地 Coding Agent 并截屏做视觉验收,零公网端口暴露。它甚至已经跑通了生产级的自我修改闭环:在沙箱克隆自身仓库、修改并通过编译和浏览器验收后推送部署,系统之外挂着一个独立看门狗,一旦改瘫自己便自动回滚。
第四块实验田,是一套多站点无人化内容运营中枢。这里沉淀出的工程纪律对我影响最深:核心代码零硬编码任何具体站点或业务,所有差异放进声明式租户配置,由自动化边界测试死守;后台看板坚持只读原则,只突出异常红灯和 waitingOnOwner 决策点,写操作全部收敛到标准 Operator API 由 Agent 执行;把老板(定原则、拍高风险板)和协调人(按授权直推标准修复并事后汇报)拆开;把现行指引、只追加的历史台账、代码注释和实时数据四类材料严格分离;批量升级采用本地逐页构建比对、先行站验证和失败即停的全局熔断。
把四块拼图摆在一起,荒诞感立刻就出来了:外部交付与强锁有了,低成本任务单与共享知识有了,远程本地执行桥与看门狗有了,核心隔离与只读塔台也有了。可现实里我同时维护着四套互不连通的待办表、三套本机执行桥和三套发布保护机制。每当我试图把它们真正合并进一套大系统,就会撞上三道绕不过去的深水区难题。
真正卡死合并的三道深水区抽象难题
第一道难题,是 Workflow 到底该写成硬状态机,还是动态 Markdown Runbook。只要系统同时并发跑着十个、一百个项目,人就必须依靠状态机看清每个项目卡在哪、谁是 Blocker。可真实业务充满细碎例外和品位判断,硬拆成几十个节点的静态 DAG 既表达不全又极难维护,最后总得退回 Markdown Runbook 让 AI 读;而几万字 Markdown 人类很难 review,并发一高人立刻失明。
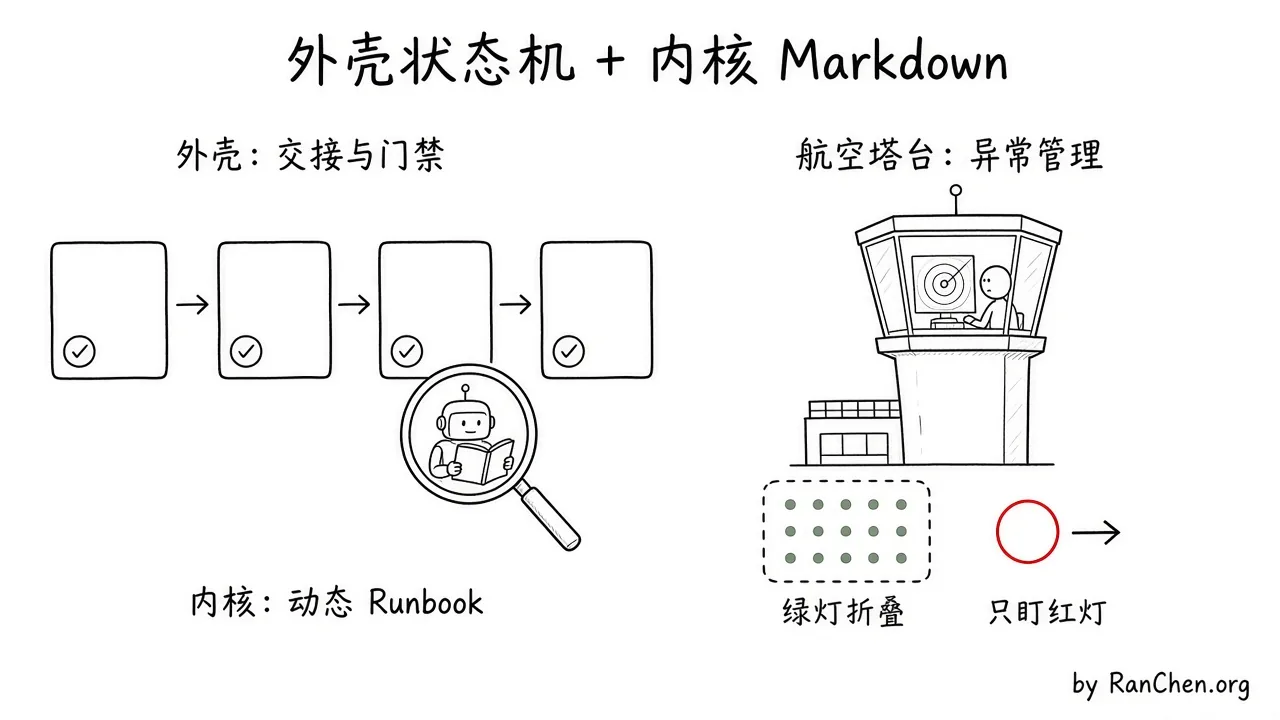
破局的关键在于承认一个朴素事实:AI 本身不需要看板或项目树,Board、Project、Workflow 的存在,本质上是为了平衡自动化自由度与人类的掌控力。 所以状态机和 Markdown 根本不该放在同一层,而应该是“壳”与“肉”的分工。外壳是极简硬状态机,里面绝不放 AI 的微观操作步骤,只放跨角色的责任交接点(Handoff)和确定性门禁(Gate),任何业务压缩下来往往只有四到六个粗阶段;阶段内部怎么应对千奇百怪的例外,全部交给动态组装的 Markdown Runbook。
对应到人类看管一百个并发项目,唯一撑得住的交互模式是航空塔台原则(Management by Exception)。塔台绝不读每架飞机的实时飞行日志,雷达上只按例外分桶:卡在我这等拍板的、门禁挂掉或租约(Lease)超时自动报红的、以及卡在客户或第三方那里的;其余绿灯正常运转的默认折叠。这张塔台表绝不靠人手工拖卡片,全由系统真相、硬门禁和心跳租约自动投影。人只审产物和红灯,不审过程流水账。
第二道难题,是统一数据底板下的多角色可见性边界。把共享的组织、联系人、项目、交付物和事件流收进同一套中心化 Schema,CRM、外联、交付就都能以插件模块长在同一个底座上。但只要外部客户、第三方外协(顾问、供应商、渠道)、内部运营和核心开发同时进入这套系统,可见性绝不能靠前端零散判断防泄密,必须下沉成内核级一等公民:每个节点、交付物和消息出生时强制标注作用域(仅内部、内部与客户、内部与指定第三方、或多方共享),默认取最窄权限。各方登录同一套系统,各自看到干净、零串台的投影,AI 调用任何对外动作也受同一套边界硬约束。
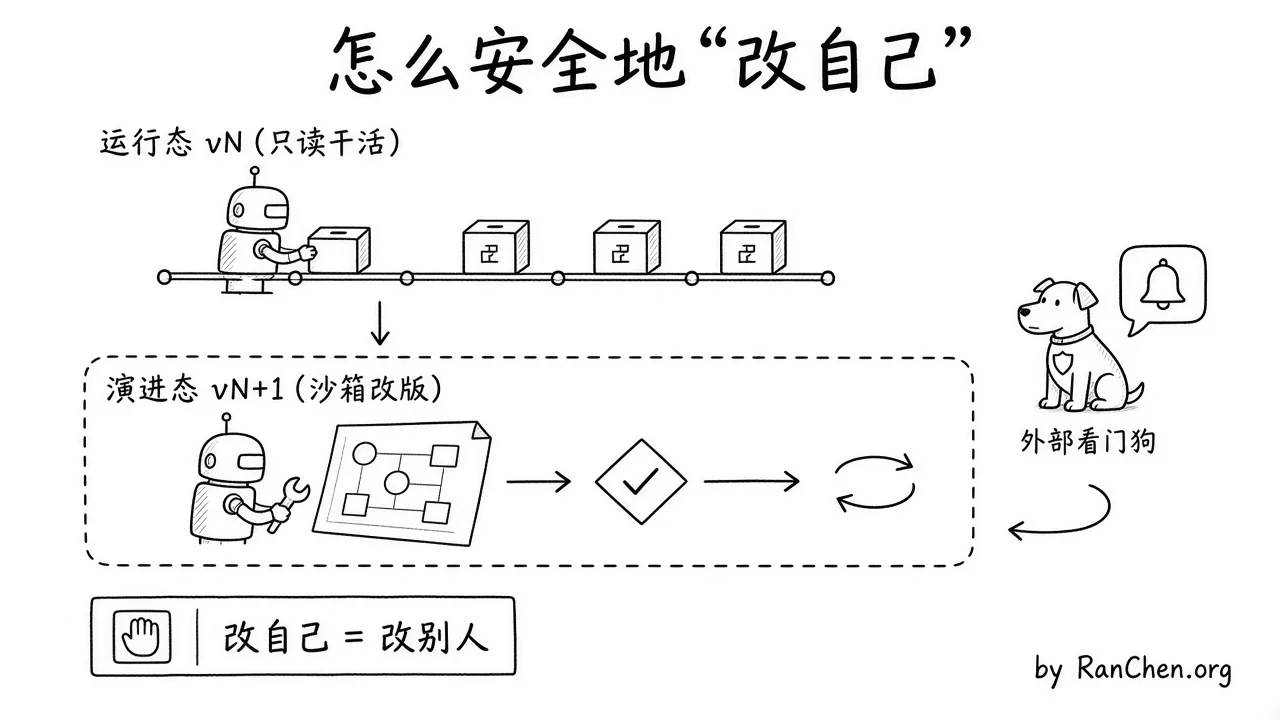
第三道,也是最烧脑的一道:全双工系统一边 7×24 干活(改别人),一边还要持续演化自己(改自己),怎么不把自己改炸? 业务散落在各自小仓库时,边跑边改字段和规则很痛快;一旦合进统一强 Schema 大系统,正在飞的流程遇上底层结构变动,复杂度立刻指数级失控。
对照编译器自举和软件工厂的经验,解开这个死循环其实靠两条硬隔离纪律:
- 按变化速度分层(Pace Layers):微内核几个月才改一次;业务模块插件严格遵守“只增不破(Expand-only)”,不破坏在飞的旧实例;而日常 80% 所谓“一边干活一边改系统”的需求(调规则、改提示词、变审批阈值、补客户记忆),全部降格成版本化数据热更新,正在跑的老任务锁死启动版本,新任务立刻生效新版,零重启、零发版。
- 运行循环(Run Loop)与演进循环(Evolve Loop)物理隔离:跑在稳定版
vN上的业务循环永远只读,严禁修改自身代码或核心 Schema,遇到缺字段或规则漏洞只能向演进循环投递一张演进工单(Meta-Task)。对运行中的vN而言,源码仓库里待构建的vN+1就是另一个外部项目:演进 Worker 在隔离 Worktree 与沙箱分支库里修改vN+1,拿生产快照跑回归彩排,过完硬门禁交给核心开发审 Diff,原子切换上线,再由外部独立看门狗兜底回滚。
一旦建立起版本隔离与沙箱晋升,逻辑上就不再有危险的“运行时自改”——系统永远只把下一个版本的自己当成外部项目来构建,“改自己”就此降维成了我们已经熟练掌握的“改别人”。
理想环境长什么样,以及 2026 年底生态的真实 Gap
把上面的碎片拼齐,2026 年底我真正想要的 AI 环境其实非常克制:云端只跑极轻的中心化控制面(统一实体底板、多角色可见性门户、只读塔台、持久化事件队列,几乎不烧按量模型费);本地常开机器承载全双工算力面(轻量非阻塞 Router 按事件唤醒,拿租约的隔离 Worker 池吃满本地订阅与大仓库上下文,并支持核心开发随时无缝接管);外围配一套沙箱回归与独立看门狗保护的演进回路。
拿这张图纸对照 2026 年底最前沿的开源与平台生态,进步非常迅猛,但共同的工程鸿沟也一目了然。
| 赛道与代表项目 | 已经验证或解决的关键环节 | 距离理想形态的真实 Gap |
|---|---|---|
| 全双工编排原型 DeepSeek dsh-superagent |
Router-Worker 全双工解耦、注意力过滤与 observe 到 auto 渐进信任 |
研究原型;仅原生支持单 GitHub 仓库;本地高权限缺硬沙箱;长周期状态膨胀未解 |
| 多 Agent 协同总线 Vercel Board 与 Vercel Eve |
频道、线程、15 分钟任务租约、依赖树、事件唤醒与延迟自检,配合 Eve 1.0 耐用工作流 | Board 尚处实验期;纯内部通信层,无业务底板、CRM 与外部多租户门户;默认偏向云端按量 API |
| 编码工厂与零人公司 OpenAI Symphony、Paperclip、Vibe Kanban |
后台调度规范(SPEC.md)、多 CLI 编排、预算上限、并发限流与并行 Worktree |
聚焦单仓库编码或内部虚拟组织;多 Agent 接力易上下文漂移与错误级联;缺外部客户与第三方可见性 |
| 耐用执行引擎 Restate、Temporal、Inngest、Vercel Workflow |
工业级 Suspend/Resume 挂起恢复,等人类审批几天零算力消耗、幂等防重发 |
默认为云端 API Agent 设计,对接本地订阅制 CLI 执行节点仍需自建桥接 |
把这些项目放到同一平面上,全行业在 2026 年底依然卡在五个清晰的 Gap 上:
- 单仓库假设:主流编排器默认世界只有一个代码库,跨多仓库与中心业务数据库的联合协调几乎空白。
- 本地订阅算力未成一等公民:云端框架默认按量烧 Token,本地编排器又普遍在宿主机硬沙箱、订阅窗口限流退避和公网稳定接入上过于简陋。
- 中途无损转向(Mid-Flight Steering)仍未过关:今天多数所谓全双工只做到 Router 不阻塞、异步派发 Worker。底层 Coding CLI 跑到一半时,如何不粗暴杀进程、不浪费前十分钟工作就平滑注入新指令,同时避免长会话反复重读历史刷爆额度,至今缺少优雅解法。
- 外部多角色业务层空白:开源圈几乎全在卷内部“Issue 到 PR”,真正把外部客户、第三方协作者、合规审批锁和 CRM 底板放进 AI-native 底座的产品寥寥无几。
- 跨层自演化管线缺失:带数据库 Schema 迁移与生产快照回放的安全自修改,依然高度依赖核心开发手工把关。
2027 年能到吗?把“等开源”和“自己沉淀”切开
回到开篇的问题:这套我想要的 AI 环境,2027 年我们能到达吗?
我的判断很直接:底层运行时工程(A 类难题)大概率能在 2027 年跨过可用门槛;上层业务抽象与治理契约(B 类难题),永远不会有哪个开源项目替你做好。
全双工路由、中途 Steering、耐用租约与挂起恢复、轻量本地沙箱、多订阅额度退避,这些是全行业共用的通用管道。2026 年底原型和 1.0 已经密集落地,照这个迭代速度,2027 年收敛出两三套稳健开源底座是大概率事件。想通这点,我反而不再为“迟迟不敢一次性硬合并所有系统”而内耗——现在花几个月自己从零硬搓一套重型分布式全双工运行时,性价比极低,半年后大概率被成熟开源基础设施碾过。
反过来,决定一套系统能不能长期跑稳、能不能自然 scale up 的,是那些任何外部框架都替你定不了的规则:核心与租户的隔离边界、跨业务实体口径、多角色可见性、人机授权红线与确定性门禁。就像我在《什么重要,什么不重要:AI Coding 落地里的 Intellectual Honesty》里写过的,口径和归属权说不清楚,换再强的工具也只是加速制造混乱。
所以在等 2027 年开源运行时成熟的窗口期里,最务实、永远不会白费的准备只有三件:
- 守住同一套业务抽象纪律:后续每起一个新模块,都坚持核心与租户分离、只读异常塔台、标准写接口和内核级可见性,不再往仓库里堆新的孤岛状态文件。
- 用标准协议把中心能力暴露出来:把核心查询、待办状态和受控写操作逐步封装成标准 MCP 接口。接口够干净,明年无论哪一套全双工运行时胜出,都能直接插上来用,不必推倒重写业务。
- 用四条硬标尺持续筛开源工具:只看它能否真正做到全双工中途转向、是否原生支持挂载本地订阅 CLI、是否自带耐用租约与依赖恢复、以及是否愿意把我们自己的数据库当真相源而非把数据锁进它的黑盒。
2027 年,底层的发动机和变速箱大概率会按时就位。到时候能不能真正跑出我想要的 AI 环境,取决于在那一天之前,我们有没有先把自己的底盘、数据骨架和交通规则修齐整。
继续阅读
全部内容
什么重要,什么不重要:AI Coding 落地里的 Intellectual Honesty
最近跟一家公司的团队聊了快两个小时,主题是 AI coding 到底怎么在公司里落地。老板在,开发、测试、产品都在,我在 Pure Global 的搭档 DJ 中途也上来了。 老板开场就讲了他们的困惑:几个月前,几个人扑在上面,想用 AI 把一个内部的 CRM 重写一遍,做了几个月,最后也没上线。他觉得“哪个地方有点问...

AI 如何重构硅谷:复盘我 2025 年 6 月在一场 CEO Club 上的分享
翻出 2025 年 6 月中旬我在上海参加一场医药产业 CEO Club 闭门活动时的录音,今天再听一遍,我自己都觉得很有意思。 那是我在旧金山待了五年之后第一次回国。当时我们公司的合伙人拉我去给一家大型医药集团和旗下产业基金生态里的几十家医药、医疗器械企业做一场闭门分享,题目叫《AI 如何重构硅谷》。 上台之前,我以...
AI 杀死了我容忍弱智的能力
在硅谷待久了,你会发现一个很奇怪的现象。 这里到处都是聪明人。名校毕业,大厂经历,创业融资,算法、系统、产品、增长,每个人都能讲得头头是道。但只要大家坐到一起,活动也好,饭局也好,办公室闲聊也好,很多对话最后都会滑向同一个方向: 谁到底是弱智? 老板是弱智,员工是弱智,同事是弱智,产品经理是弱智,扎克伯格简直是个大弱智...