支持向量机(SVM)是什么意思?

大部分答案都在写公式,我来聊聊直觉上的东西。
设想一下你要做一个分类器,区分狗和炸鸡。首先假定我们只有两个数据,那么这条线会很容易画,自然而然就会画在正中间。
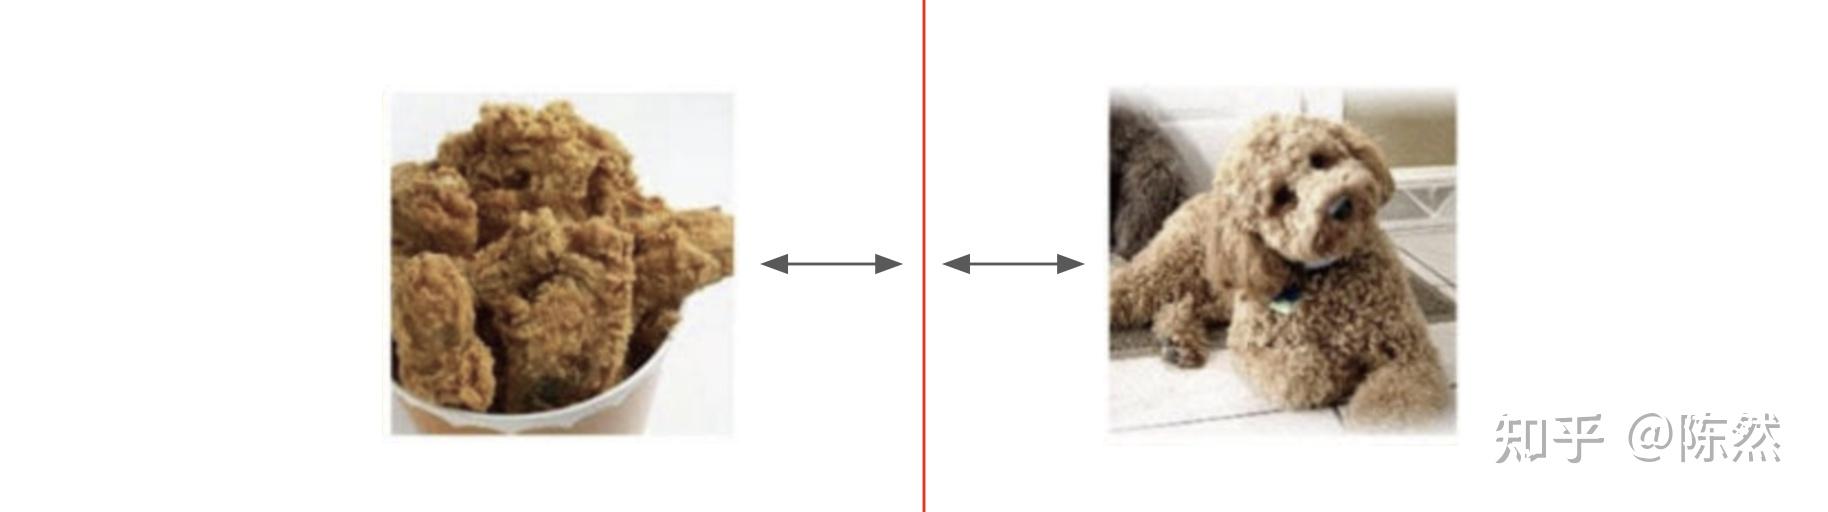
这个时候,我们加入一个新的数据,这个狗跟现有的数据差别很大。这个时候,分类线应该画在哪里?
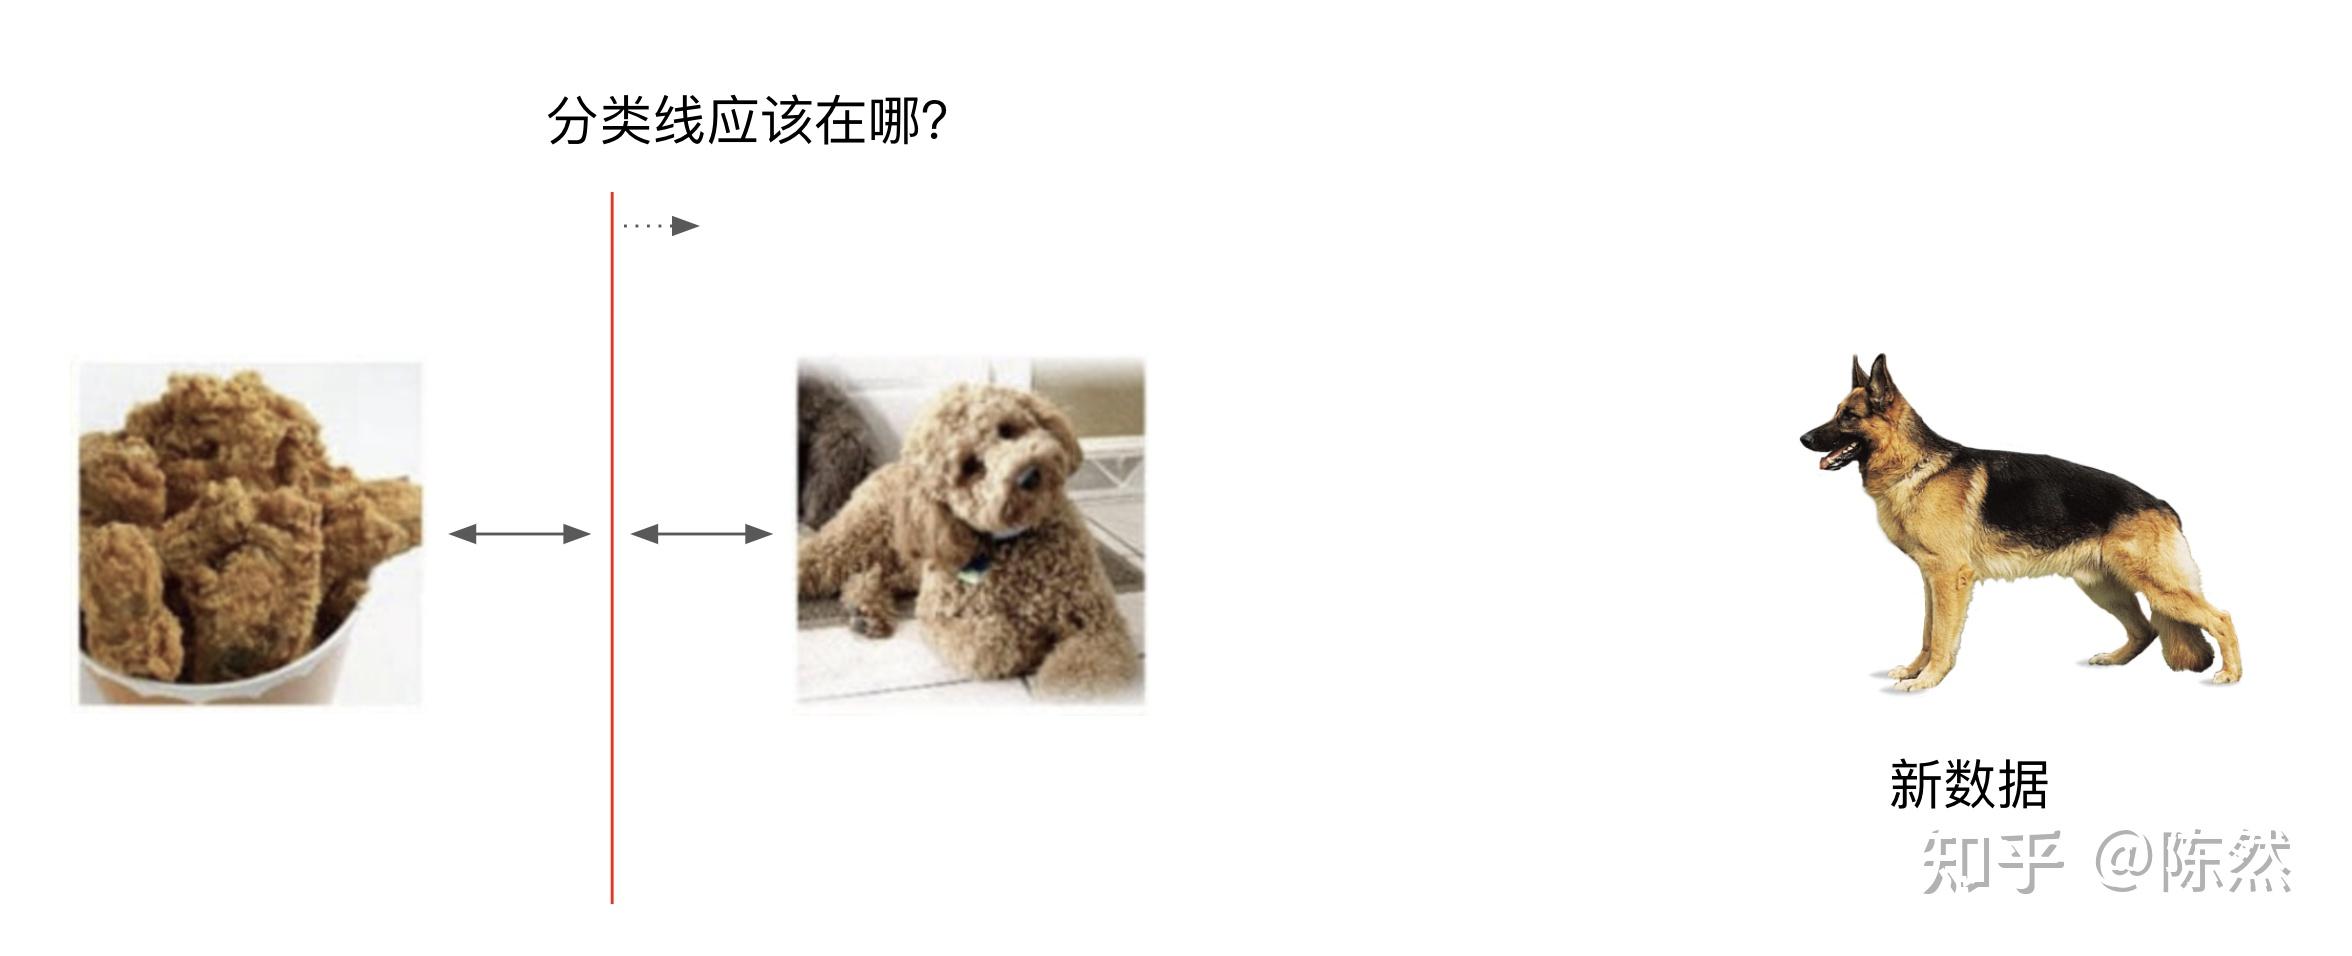
这就是 SVM 跟其他线性模型很不一样的地方了,SVM 这条分类线不会变化,依然在两者的正中间,但是其他的线型模型,比如 LR,就会偏移一些。
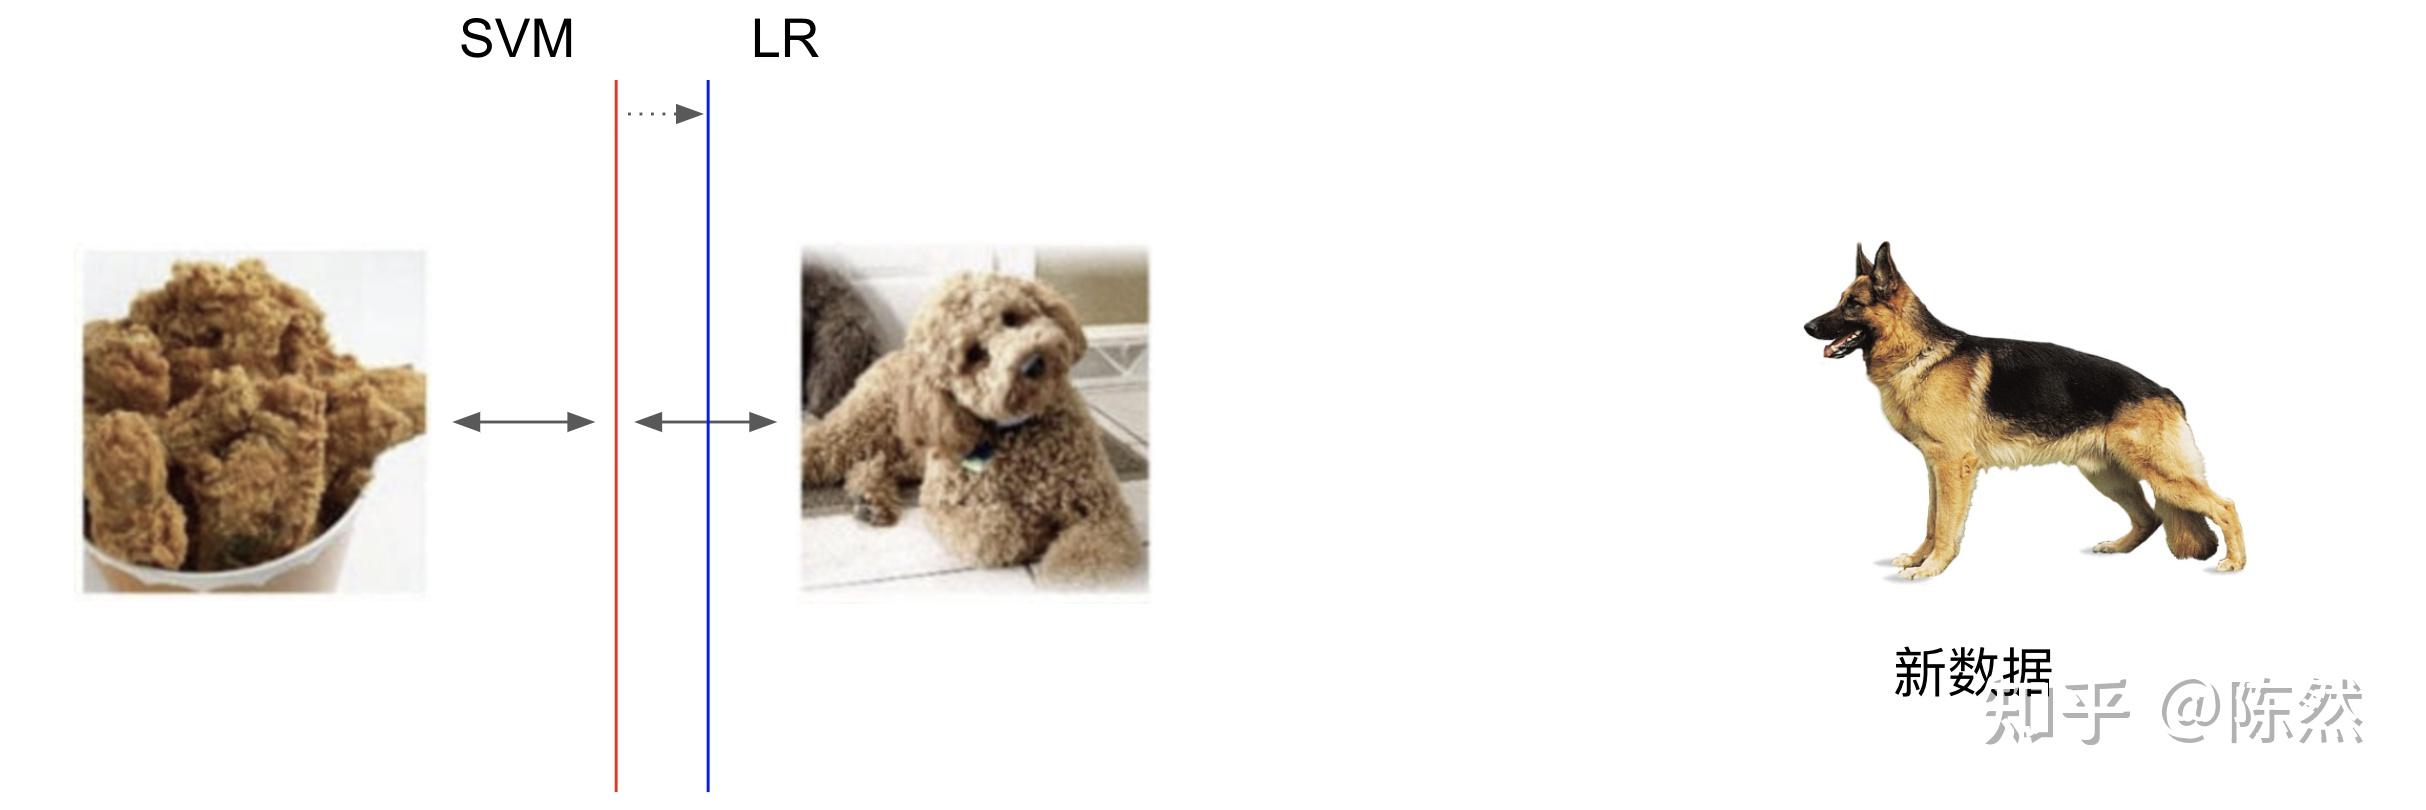
这就是 SVM 一个很好的性质了:分类的平面,只跟部分数据(support vector)有关,而且是最“相似”,最容易“相互混淆”的那部分数据,与其他的绝大部分数据都无关。我们移走或者增加那些本身就距离很远的数据,对于分类结果没有改变,但是如果我们能给出更多的“相似”的数据,打上精准的标签,那分类结果就会更精确。
这个性质引申出 SVM 一些很好的特性:
- 对于数据的要求很低,不要求数据符合什么样的分布,只要存在边界就可以,模糊的边界也可以。
- 过拟合的概率不高,因为决定那条线的数据量很少。
- 在抽样的数据上依然会表现的很好。
- Outlier 对于分类的影响非常小。
SVM 的劣势是作为一个线型模型,分类的边界只能是线型的的,哪怕用了 kernel 升维度,在高维度也是线型的,kernel 的选择对于数据的分布有特定的假设。
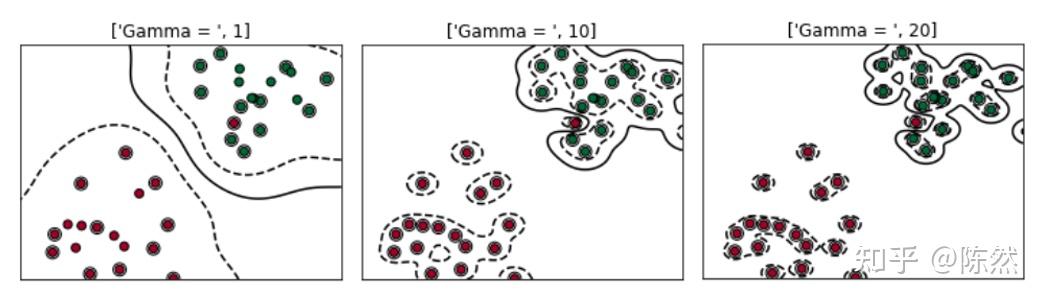
Radial Basis Function (RBF) kernel SVM
作为对比,常见的树模型的分类边界就可以是多个线型的叠加组成非常复杂的任意曲线。因此,在实战操作中,树模型比如 XGBoost 还是更容易上手,大概率表现更好一些。
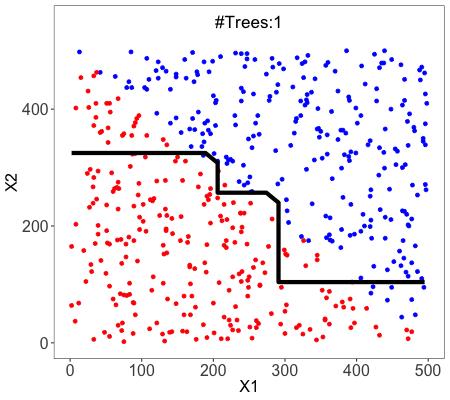
树模型的分类边界
继续阅读
全部内容
Alexandr Wang 和 Lecun,谁对 Meta 更重要?
谢邀。作为一名身处硅谷一线的AI创业者,这个问题恰好击中了我一直在思考的核心。它看似在比较两个人,实则是在拷问一家科技巨头在当下这个“大重构”时代,究竟该如何选择自己的生存之道。 长话短说,我的核心观点是:在这个充满不确定性的时代,最重要的不是“做对”,而是通过快速试错来获得“信息增量”。因此,谁能帮助Meta更快、更...
为什么苹果公司在ai领域起了个大早赶了个晚集?
我有一个妙计,既然 Meta 最近在疯狂招人,不如 Apple 来一个釜底抽薪,直接收购 Meta,直接解决 Apple 在 AI 领域的问题。 下面是 AI 给出的详细计划: 苹果收购 Meta 的“神级”实施计划 0 · 战略总述 1. 一步到位补齐 AI 短板 Meta 正在用「Zuck Bucks」千金砸人,疯...
Meta 宣布成立「超级智能实验室」,其豪华团队阵容透露了哪些信息?未来可能会在哪些方面发力?
多数人把 Meta 超级智能实验室(MSL)看成一场“更大模型”军备赛。但我认为,扎克伯格真正想造的不是下一只 GPT,而是一套“AI 原生操作系统”——一个结合数据供应链、开发者生态和跨端硬件的全栈平台。模型只是其中一个可替换的插件,而不是终局。 团队构成指向“数据炼油厂 + 开发者平台” Alexandr Wang...